/ Proyectos / Agritech / Predicción en tanques de piscicultura
Predicción de variables en tanques de piscicultura: IoT, benchmark de modelos y alertas de recambio de agua
Cómo diseñar un pipeline de predicción a corto plazo para temperatura, pH y compuestos nitrogenados a partir de sensores IoT, eligiendo el modelo correcto para el horizonte correcto y sin dejar el sistema indefenso ante una caída de sensor.
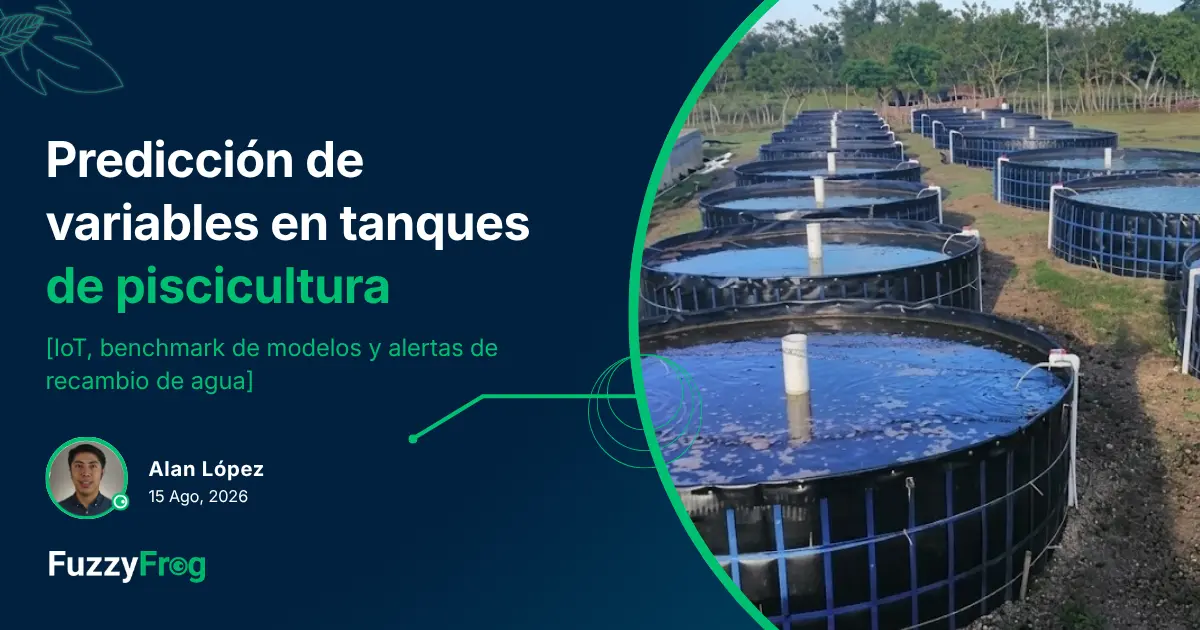
El objetivo era anticipar, con 15 a 30 minutos de margen, cómo iban a comportarse las variables críticas de un tanque de piscicultura, temperatura, pH, conductividad, TDS, amonio, nitrito y nitrato, a partir de lo que reportan los sensores IoT del tanque. No para reemplazar al operador, sino para darle una ventana de reacción antes de que un valor cruzara el umbral que obliga a un recambio de agua.
El reto no empezaba en el modelo. Empezaba en la hoja de datos del sensor: entender su resolución, su latencia y la frecuencia con la que publica al broker MQTT, porque eso es lo que define qué horizonte de predicción es honesto pedirle a cualquier algoritmo. Con esa base, se corrió un benchmark comparativo entre persistencia, regresión lineal, Random Forest y SARIMA, y se construyó una capa de alertas de recambio de agua y una estrategia de contingencia explícita para cuando un sensor deja de reportar.
Mapa del casoContenido
- Diagrama de la solución. De la lectura del sensor a la alerta de recambio de agua
- Construcción de la solución. Cómo el diseño del sensor y el desbalance de riesgo dirigieron cada decisión
- Condiciones del proyecto. Restricciones reales y opciones descartadas antes de construir
- Pasos. Qué se dejó al agente y qué criterio se aplicó en cada uno
- Proceso de iteración. El resultado inesperado que descartó un modelo completo
- Descargables. Notebook, diagrama y repositorio del proyecto
- Lecciones importantes. La lección concreta que deja este caso
Estructura de alto nivelDiagrama de la solución
Pasa el cursor sobre cada bloque para ver qué hace ese paso.
La capa de alertas de recambio de agua corre en paralelo al modelo, no depende de él: si el modelo se degrada o el sensor cae, las reglas de umbral y la estrategia de contingencia siguen funcionando de forma independiente.
Del sensor al modelo en producciónConstrucción de la solución
Condiciones del proyecto
| Restricción | Dato |
|---|---|
| Horizonte de predicción requerido | 15 y 30 minutos, no más, por la naturaleza operativa de la alerta |
| Frecuencia de envío del sensor | Una lectura cada 15 minutos vía MQTT (broker tipo Mosquitto) |
| Variables críticas | Temperatura, pH, conductividad, TDS, amonio, nitrito, nitrato |
| Confiabilidad de la conexión | Caídas de sensor recurrentes, de duración variable, no siempre cortas |
| Opción | Por qué se descartó |
|---|---|
| Diseñar el modelo sin revisar la hoja de datos del sensor | Habría llevado a prometer un horizonte de predicción que la resolución y frecuencia del sensor no pueden respaldar |
| SARIMA como modelo principal, por capturar mejor el ciclo diario en teoría | En el benchmark real resultó frágil ante los huecos de datos y con peor desempeño que alternativas más simples |
| Depender solo de la predicción del modelo para decidir un recambio de agua | Si el modelo se degrada o el sensor cae, el sistema se queda sin ninguna señal de seguridad |
| Random Forest sobre lags + hora del día, con capa de reglas de umbral y contingencia independientes | Mejor balance error/costo operativo para el horizonte corto, y una red de seguridad que no depende del modelo |
Pasos
Revisión del sensor antes de tocar el modelo
Agente: propuso empezar directamente con la ingeniería de características sobre los datos históricos.
Criterio aplicado: primero confirmar resolución, latencia y frecuencia de envío del sensor, porque esos tres factores acotan qué horizonte de predicción tiene sentido ofrecer, antes de invertir tiempo en cualquier modelo.
Benchmark comparativo antes de elegir modelo de producción
Agente: sugirió ir directo a Random Forest por ser el modelo más común en proyectos similares.
Criterio aplicado: correr un benchmark con persistencia, regresión lineal, Random Forest y SARIMA sobre la misma ventana de datos, para decidir con evidencia y no por costumbre.
Alertas de recambio de agua como capa de reglas, no como salida del modelo
Agente: propuso derivar la alerta directamente de la predicción del modelo.
Criterio aplicado: implementar los umbrales de amonio, nitrito, nitrato y pH como reglas fijas e independientes, evaluadas tanto sobre el dato observado como sobre la predicción, para que la alerta no desaparezca si el modelo falla.
Estrategia de contingencia ante caída de sensor
Agente: no contempló el caso de pérdida de conexión del sensor en el diseño inicial.
Criterio aplicado: definir explícitamente cuánto tiempo se sostiene la última lectura válida antes de degradar la confianza de la predicción, y a partir de qué punto se escala a una alerta manual para intervención del operador.
Proceso de iteración
Ajuste documentado, no forzado
SARIMA, el modelo del que más se esperaba por su capacidad teórica de capturar el ciclo diario del pH, terminó con un R² negativo (-2.61) sobre el conjunto de prueba, muy por debajo incluso de la persistencia ingenua (R² 0.83). El ajuste estacional resultó demasiado sensible a los huecos de datos interpolados por las caídas de sensor, y el modelo no generalizó bien fuera de la ventana de entrenamiento. Random Forest y regresión lineal, en cambio, quedaron prácticamente empatados (R² 0.885 y 0.890, RMSE de 0.037 y 0.036 en unidades de pH). Se documenta el fracaso de SARIMA tal como salió, sin forzar una interpretación más favorable, porque es información real sobre qué enfoques no sirven para este tipo de dato ruidoso e intermitente.
CierreLecciones importantes
Un proyecto de IoT se diseña dos veces: una en la hoja de datos del sensor y otra en el notebook, y la primera decide qué es posible pedirle a la segunda. La otra lección fue de honestidad: el modelo teóricamente más sofisticado (SARIMA) fue el que peor funcionó en la práctica, y reportarlo así, sin maquillar el resultado, es lo que permite decidir con criterio cuál modelo sí llevar a producción.
Si quieres ver un enfoque publicado con una idea similar, comparación de modelos de complejidad creciente para predicción de calidad de agua en dispositivos de bajo costo, este trabajo es una buena referencia del nivel de la contribución: Machine Learning on Low-Cost Edge Devices for Real-Time Water Quality Prediction in Tilapia Aquaculture.
Termina ya tu proyecto
¿Tienes un proyecto similar y no sabes por dónde empezar? Yo te ayudo a diseñarlo.
El 92% de los profesionales de datos desbloquea sus proyectos al ver ejemplos completos resueltos.
Sin registro. Acceso inmediato