/ Proyectos / Gobierno / Detección de caracteres en documentos
Detección y clasificación de caracteres en documentos: combinando OCR y una CNN propia
Extracción de texto en documentos oficiales fusionando un motor de OCR clásico con un clasificador de caracteres entrenado desde cero, para reforzar las zonas donde el OCR genérico pierde precisión.
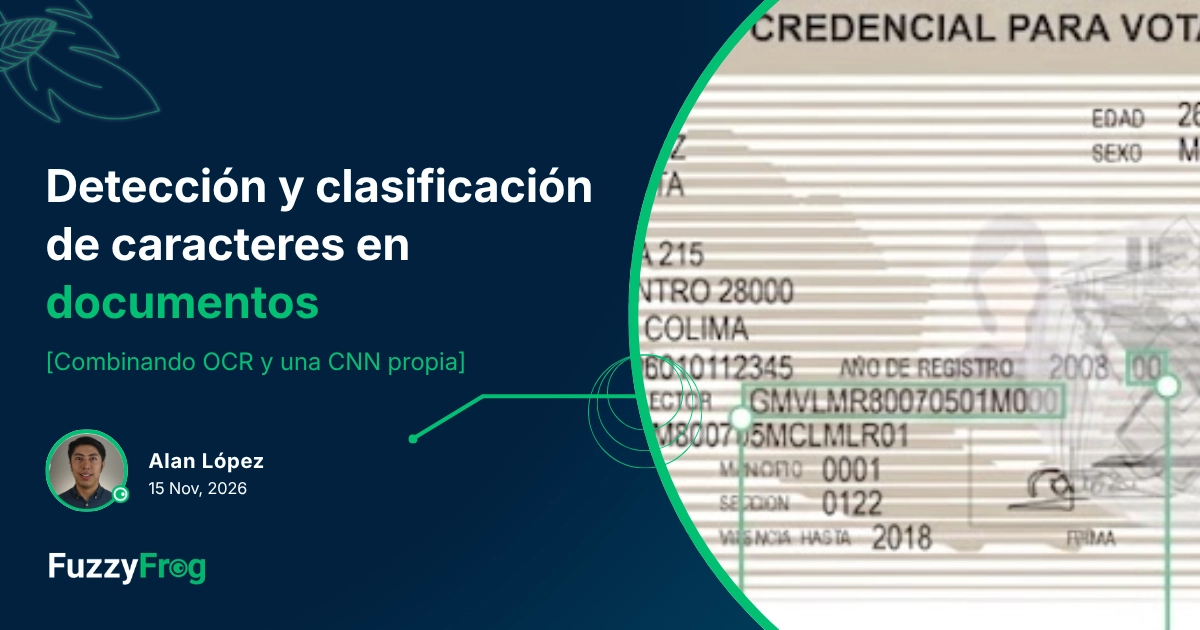
El objetivo era extraer el texto de un documento oficial a partir de una imagen escaneada o fotografiada, sin depender únicamente de un motor de OCR genérico. El problema real: la calidad de imagen varía mucho entre documentos, y un motor de OCR "de caja" detecta bien el texto nítido pero se equivoca con ruido en zonas de bajo contraste, sellos de fondo o fotografías de baja resolución.
Se diseñó un pipeline en dos capas: Tesseract para la detección inicial de palabras y caracteres, y un clasificador de caracteres propio, una CNN pequeña entrenada con un dataset sintético de fuentes tipográficas, para reforzar el reconocimiento en las zonas donde el motor genérico falla. El hallazgo más importante no fue del modelo, fue de los datos de entrada: la calidad de la imagen original determina más el resultado final que cualquier ajuste posterior al pipeline.
Mapa del casoContenido
- Diagrama de la solución. Los bloques del pipeline, de la imagen de entrada al documento estructurado
- Construcción de la solución. Cómo la calidad real de la imagen dirigió cada decisión
- Condiciones del proyecto. Restricciones reales y opciones descartadas antes de construir
- Pasos. Qué se dejó al agente y qué criterio se aplicó en cada uno
- Proceso de iteración. El ajuste documentado entre el primer y segundo intento
- Descargables. Notebook, diagrama y repositorio del proyecto
- Lecciones importantes. La lección concreta que deja este caso
Estructura de alto nivelDiagrama de la solución
Pasa el cursor sobre cada bloque para ver que hace ese paso.
El preprocesamiento se aplicó antes de la detección, no después, porque corregir la imagen de entrada resultó más determinante para el resultado final que cualquier ajuste hecho sobre el texto ya detectado.
De la teoría a la prácticaConstrucción de la solución
Condiciones del proyecto
| Restricción | Dato |
|---|---|
| Fuente de las imágenes de documento | Especímenes de muestra públicos, sin datos personales reales |
| Dataset para el clasificador de caracteres | No existía un dataset propietario etiquetado disponible |
| Calidad de imagen esperada en producción | Variable: desde escaneo plano hasta foto de campo con reflejos y ángulo |
| Restricción de privacidad | Ningún dato personal identificable puede procesarse ni almacenarse en el pipeline de ejemplo |
| Opción | Por qué se descartó |
|---|---|
| Usar solo Tesseract sin preprocesamiento ni clasificador propio | Suficiente en condiciones ideales, pero se degrada rápido con baja resolución o contraste |
| Entrenar el clasificador con un dataset real de caracteres manuscritos etiquetado a mano | Costoso de anotar y no disponible para este caso; el dataset sintético por fuente cubre el mismo problema sin ese costo |
| Preprocesamiento + OCR + clasificador CNN propio como refuerzo en zonas de baja confianza | Combina la cobertura general de un OCR probado con precisión adicional donde más falla |
Pasos
Diagnóstico de la imagen de entrada
Agente: propuso correr Tesseract directo sobre la imagen cruda sin más análisis.
Criterio aplicado: primero medir resolución y contraste de cada imagen, porque de eso depende cuántas palabras se detectan correctamente antes de tocar ningún parámetro del OCR.
Preprocesamiento antes de la detección
Agente: sugirió ajustar solo los parámetros de configuración de Tesseract (`--oem`, `--psm`).
Criterio aplicado: agregar upscaling, suavizado y binarización con Otsu antes del OCR, porque la imagen de entrada es la variable con más impacto en el resultado, no la configuración del motor.
Generación del dataset sintético de caracteres
Agente: propuso buscar un dataset público de caracteres impresos en internet.
Criterio aplicado: generar el dataset renderizando cada carácter en distintas tipografías con variación de tamaño, posición y ruido, para controlar exactamente qué variabilidad aprende el modelo.
Elección del clasificador de caracteres
Agente: propuso ir directo a una arquitectura CNN sin comparar contra nada más simple.
Criterio aplicado: entrenar primero un baseline de regresión logística sobre los píxeles crudos, y solo justificar la CNN si superaba ese baseline por un margen claro.
Proceso de iteración
Ajuste documentado, no forzado
El primer intento, Tesseract directo sobre la imagen cruda, produjo tokens sin sentido mezclados con palabras válidas en la muestra de menor contraste. El preprocesamiento (upscaling + binarización) sí aumentó la cantidad total de tokens detectados en ambas muestras, pero no "limpió" el resultado: subió tanto las palabras correctas como el ruido. La conclusión honesta es que el preprocesamiento ayuda pero no resuelve el problema por sí solo, hace falta una etapa de validación posterior sobre lo que el OCR devuelve.
CierreLecciones importantes
La calidad de la imagen de entrada pesó más en el resultado final que cualquier decisión de modelado. El preprocesamiento subió tanto el texto correcto como el ruido, así que agregarlo no reemplaza una etapa de validación: solo cambia qué tan grande es el problema que esa validación tiene que resolver después. El dataset sintético de caracteres, generado por fuente sin depender de datos reales, fue suficiente para entrenar un clasificador con exactitud alta, una alternativa útil cuando no hay acceso a un dataset etiquetado.
Si quieres ver un enfoque publicado con una idea similar, digitalización de documentos combinando detección de texto y clasificación de caracteres, este paper es una buena referencia del nivel de la contribución: TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models.
Termina ya tu proyecto
¿Tienes un proyecto similar y no sabes por dónde empezar? Yo te ayudo a diseñarlo.
El 92% de los profesionales de datos desbloquea sus proyectos al ver ejemplos completos resueltos.
Sin registro. Acceso inmediato