Predicción de resistencia del cemento con ML: Random Forest, validación temporal y bootstrap
Sigue leyendo si vas a construir un pipeline de Machine Learning sobre datos reales de producción «tesis, trabajo o portafolio» y no te basta con copiar código: quieres entender por qué se tomó cada decisión «dividir por fecha o al azar, predecir a 1 día o a 28» para poder desarrollar tu propio proyecto sobre datos de proceso o de control de calidad.

Parte 1 de 3
Contexto del proyecto
Al terminar, sabrás hacer esto
No son conceptos abstractos. Son decisiones que podrás tomar y justificar en una tesis, en una entrevista o en un proyecto real de control de calidad industrial.
- Separar predictor de resultado disfrazado: distingues cuándo una columna disponible en tu CSV es en realidad otra medición del mismo resultado que quieres predecir, y la excluyes del entrenamiento aunque esté ahí.
- Validación temporal real: divides datos de producción por fecha, no al azar, y mides con evidencia propia cuánto se infla la métrica cuando no lo haces.
- Reducción dimensional sin fuga: ajustas
VarianceThresholde imputación únicamente con el conjunto de entrenamiento, dentro del mismoPipelineque el modelo. - Benchmarking honesto: comparas Random Forest, SVR y KNN con validación cruzada, sin tocar el conjunto de prueba hasta que ya elegiste y afinaste un ganador.
- Estabilidad medida bien: corres bootstrap sobre el entrenamiento y evalúas siempre contra el mismo conjunto de prueba nunca visto, en vez de inflar la estabilidad reportada evaluando contra datos ya conocidos.
- Despliegue real: empaquetas el modelo afinado como una API con FastAPI, sin ninguna credencial escrita en el código, y la pruebas con una solicitud real.
- Criterio para adaptarlo: identificas en qué punto del pipeline tocar el código si cambian tus datos, tu variable objetivo o tu modelo, y cómo confirmar que el cambio realmente mejoró algo.
Modos de uso
- Tesis: replicación crítica de un pipeline de regresión sobre datos reales de proceso, comparado contra el propio checklist metodológico del proyecto.
- Trabajo: pipeline de control de calidad predictivo, replicable con cualquier dataset de producción con fecha.
- Portafolio: demuestra que sabes evaluar un modelo sin fugas y justificar la elección de variable objetivo, no solo entrenarlo.
Prerrequisitos
- Python intermedio: funciones, listas/diccionarios, y haber usado pandas alguna vez. No necesitas ser experto.
- Nociones de estadística básica: qué es una media, una mediana y una desviación estándar. Se usa constantemente en la imputación y en la evaluación.
- Cero experiencia previa en química del cemento o en control de calidad industrial. Eso es justo lo que cubre la siguiente sección.
Brief del proyecto
La resistencia a la compresión es la propiedad más importante del cemento: mide cuánta carga soporta antes de fallar. Se prueba dejando curar una muestra y rompiéndola bajo presión, en un laboratorio, con una prensa.
El problema es el tiempo. El estándar de la industria es medir la resistencia a los 28 días, porque para entonces el cemento ya completó casi todo su proceso de curado y el número es confiable. Pero 28 días es mucho tiempo para descubrir que un lote salió mal.
Si la composición química de ese lote «cuánto clínker, cuánto yeso, cuánta caliza» ya predice, aunque sea de forma imperfecta, qué tan resistente va a terminar siendo, un control de calidad puede tener una alerta temprana mucho antes de esperar el mes completo.
Ahí es donde entra Machine Learning: en vez de tratar la resistencia como algo que solo se conoce rompiendo una muestra en el laboratorio, se trata como algo que se puede predecir desde la composición, con un modelo entrenado sobre miles de muestras reales de producción.
El reto no es solo entrenar un modelo que prediga razonablemente bien. Es hacerlo sin caer en los dos errores que más se repiten en datos de producción real: dejar que el split entre entrenamiento y prueba mezcle información del mismo lote, y dejar que una de las cuatro mediciones de resistencia «a 1, 3, 7 o 28 días» se cuele como si fuera una variable predictora independiente, cuando en realidad es la misma muestra madurando.
La Figura 2 muestra cómo se resuelven ambos problemas, en el orden en que se resolvieron.
Diagrama de la solución
El pipeline responde dos preguntas en orden, y la respuesta de la primera es el insumo de la segunda (Figura 2).
Datos y fricción real
Los datos son mediciones reales de control de calidad de una planta de cemento: 1,997 muestras tomadas entre diciembre de 2019 y marzo de 2022, cada una con fecha, hora, composición química completa y las cuatro mediciones de resistencia a la compresión.
- 39 columnas en crudo, de las cuales 32 son variables de composición y de proceso legítimas como predictoras, 4 son mediciones de resistencia «el resultado, en sus distintas edades» y 3 no aportan valor predictivo «fecha, hora y una descripción de texto libre del lote».
- Huecos reales de planta: 17 de las 32 columnas predictoras tienen valores faltantes, casi todos mínimos «entre 0.06% y 0.31% de las filas», salvo pérdida por ignición «0.31%» y cal libre «0.13%». No son huecos inventados para el ejercicio, son sensores y lecturas de laboratorio que en la práctica no siempre se registran.
- Varias columnas casi constantes: algunos óxidos menores varían tan poco entre muestras que aportan más ruido que señal. Eso es justo lo que resuelve la reducción dimensional de la Etapa 4.
Dataset servido en vivo desde un CSV público de FuzzyFrog.AI, pensado para reproducir este pipeline sin depender de ningún acceso privado.
Fundamentos teóricos de la solución
¿Qué es la resistencia a la compresión del cemento y por qué se mide a varias edades?
Cuando el cemento se mezcla con agua, empieza una reacción química «hidratación» que lo endurece de forma progresiva, no instantánea. La resistencia a la compresión es la carga máxima que soporta una muestra antes de fallar, y se mide rompiendo probetas en distintos momentos de ese proceso: a 1, 3, 7 y 28 días.
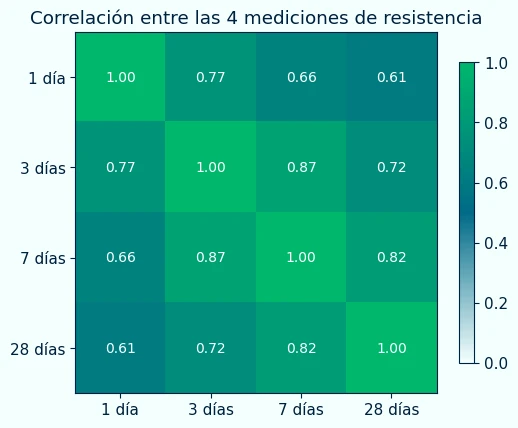
Las cuatro mediciones son la misma muestra en distintos puntos de la misma curva de endurecimiento. Por eso están altamente correlacionadas entre sí «lo verás en la Figura 3», y por eso ninguna puede tratarse como una variable predictora independiente de las otras: usar la resistencia a 3 días para predecir la de 28 sería, en esencia, dejar que el modelo vea el resultado antes de predecirlo.
La composición química influye en qué tan rápido y qué tan fuerte endurece la mezcla: el clínker aporta la mayor parte de la resistencia final, el yeso regula el tiempo de fraguado, la caliza actúa como relleno y modifica la reactividad. Ese es el vínculo que el modelo intenta capturar.
¿Qué es Random Forest y por qué le fue mejor aquí que a SVR o KNN?
Random Forest entrena muchos árboles de decisión, cada uno sobre una muestra distinta de los datos y un subconjunto distinto de variables, y promedia sus predicciones. Cada árbol individual sobreajusta a su propia muestra, pero el promedio de muchos árboles distintos cancela buena parte de ese ruido.
A diferencia de SVR o KNN, no necesita que las variables estén perfectamente escaladas para funcionar bien, porque cada árbol solo compara una variable a la vez contra un umbral, no distancias entre puntos en un espacio de 20 dimensiones. Con variables de composición química en escalas muy distintas «un óxido menor en 0.05% junto a la superficie específica en miles de cm²/g», eso es una ventaja real, no solo teórica.
También entrega, de forma nativa, qué tan seguido usa cada variable para dividir el espacio, lo que sirve como una primera aproximación de qué composición pesa más en la predicción.
¿Qué es la validación cruzada y por qué importa que no haya fuga?
La validación cruzada divide el conjunto de entrenamiento en varios «folds», entrena con todos menos uno y evalúa en el que quedó fuera, repitiendo el proceso hasta que cada fold sirvió una vez como validación. Da una estimación más estable del desempeño que un solo split, porque promedia sobre varias particiones distintas.
El punto metodológico es qué se ajusta dentro de cada fold y qué se ajusta antes. Si el escalador, el imputador o el selector de variables se ajustan con el dataset completo antes de dividir en folds, cada fold de validación termina «viendo» información de las filas que en teoría no debería conocer. Por eso este proyecto arma todo dentro de un Pipeline de scikit-learn: así, cada ajuste ocurre solo con los datos de entrenamiento del fold correspondiente, nunca antes.
El conjunto de prueba final es una capa más allá de esto: ni siquiera participa en la validación cruzada. Se queda completamente afuera hasta la última celda del notebook.
Explorador de decisiones
Antes de leer cómo se construyó el pipeline, prueba tú mismo dos de sus decisiones. Es una muestra rápida — las 4 decisiones del proyecto se exploran igual, justo donde aparecen en el desarrollo.
Parte 2 de 3
Desarrollo del proyecto
¿Qué construyes?
Este proyecto integra control de calidad industrial con un pipeline de regresión evaluado con la disciplina de una serie de tiempo. Lo que lo distingue es cómo se mide: cada decisión se pone a prueba, fuera de muestra, contra la alternativa más obvia que existe «al azar en vez de por fecha, la medición más fácil en vez de la más útil».
Los datos son 1,997 muestras reales de una planta de cemento, de diciembre de 2019 a marzo de 2022, con composición química completa y las cuatro edades de resistencia medidas en laboratorio. El pipeline entrena con el 80% más antiguo y prueba contra el 20% más reciente, que el modelo nunca toca hasta la evaluación final.
Decisión clave
¿Esto es un problema de regresión o de clasificación?
Podrías plantear esto como clasificación: «¿el lote pasa control de calidad, sí o no?» Es más simple de entrenar y de evaluar. Pero el proceso necesita el valor exacto en psi, no solo una bandera de aprobado o rechazado: la diferencia entre 1,800 y 2,000 psi tiene consecuencias concretas en cómo se ajusta la mezcla del siguiente lote.
Se eligió regresión: la resistencia pronosticada en psi es un número que un ingeniero de planta puede comparar directamente contra el mínimo de especificación, no una etiqueta.
¿Y si tu caso es distinto? Si a ti te piden explícitamente una alerta binaria «¿aprobado o no?», clasificación puede bastar y es más simple de evaluar. Pero si la predicción alimenta un ajuste fino de dosificación, necesitas magnitudes: quédate con regresión.
Insight de experto: La pregunta más importante de todo el pipeline no es qué modelo usar, es ¿qué variable estoy realmente prediciendo? Con cuatro mediciones de resistencia disponibles en el mismo CSV, es fácil dejar que tres de ellas se cuelen como predictoras «tienen una correlación altísima con el objetivo, así que "mejorarían" cualquier métrica de entrenamiento». Eso no es un modelo mejor, es una fuga que nunca se sostendría en producción, porque el día que hay que predecir la resistencia a 1 día, las otras tres tampoco se conocen todavía.
Arquitectura del pipeline
- Datos: composición química y de proceso de 1,997 muestras reales de control de calidad, cargadas en vivo desde un CSV público.
- División y objetivo: split temporal 80/20 por fecha; se predice la resistencia a 1 día, y las cuatro columnas de resistencia se excluyen de las variables predictoras.
- Preparación de variables:
VarianceThresholde imputación por mediana, ambos ajustados solo con entrenamiento, dentro del mismoPipeline. - Benchmarking: Random Forest, SVR y KNN comparados con validación cruzada; el ganador se afina con
GridSearchCV. - Estabilidad y evaluación: bootstrap sobre el entrenamiento contra el mismo conjunto de prueba, y una evaluación final única sobre ese mismo conjunto.
- Despliegue: API con FastAPI, publicada temporalmente con ngrok y probada con una solicitud real.
El Diagrama de la solución (Figura 2) muestra estas mismas piezas agrupadas por la pregunta que responde cada una.
Stack tecnológico
- Python «lenguaje principal»
- pandas / numpy «carga, limpieza y manipulación de datos»
- scikit-learn «Pipeline, VarianceThreshold, SimpleImputer, StandardScaler, RandomForestRegressor, SVR, KNeighborsRegressor, GridSearchCV»
- matplotlib «todas las figuras de resultados»
- FastAPI + uvicorn «API REST para predicción»
- ngrok «túnel para exponer la API desde Colab»
- joblib «serialización del modelo entrenado»
Probado de principio a fin el 25 de septiembre de 2026 con pandas 2.2.3, numpy 2.1.3 y scikit-learn 1.6.1.
Etapa 1 de 6
Datos y reproducibilidad
Fija la semilla y el esquema de validación cruzada que reutiliza todo el resto del notebook, y carga los datos reales de control de calidad.
El proyecto corre en Google Colab o localmente. No necesita GPU: el pipeline completo, con benchmarking, afinación y bootstrap, corre en unos minutos sobre CPU.
Configuración del experimento
La semilla global y el esquema de validación cruzada viven en una sola celda, para que el resto del notebook los reutilice sin volver a declararlos. Así, dos corridas dan los mismos números, y las versiones de cada librería quedan impresas para que un resultado no se reporte sin su entorno.
import pandas as pd
import numpy as np
import sklearn
from sklearn.model_selection import KFold

SEED = 42
cv = KFold(n_splits=5, shuffle=True, random_state=SEED)

print(f"pandas       {pd.__version__}")
print(f"numpy        {np.__version__}")
print(f"scikit-learn {sklearn.__version__}")pandas 2.2.3 numpy 2.1.3 scikit-learn 1.6.1
Carga de datos
El CSV se carga en vivo desde un repositorio público de FuzzyFrog.AI, para que cualquiera pueda reproducir el pipeline sin depender de un acceso privado.
DATA_URL = "https://raw.githubusercontent.com/FuzzyFrogAI/boilerplates-datasets/refs/heads/main/cemento_data.csv"

df_crudo = pd.read_csv(DATA_URL)
print(f"CSV cargado: {df_crudo.shape[0]} filas x {df_crudo.shape[1]} columnas")CSV cargado: 1997 filas x 39 columnas
Qué significa cada dato
- Fecha y hora. Cuándo se tomó cada muestra de producción.
Descripciónes texto libre del lote, sin valor predictivo. - Composición química y de proceso. Clínker conforme y no conforme, yeso, caliza, arcilla calcinada, óxidos «SiO2, Al2O3, CaO, Fe2O3, SO3, MgO…», composición de Bogue, finura, tiempos de fraguado, expansión en autoclave y fluidez. Estas son las variables predictoras legítimas.
- RC 1 día, 3 días, 7 días y 28 días. Las cuatro mediciones de resistencia a la compresión de la misma muestra, a distintas edades de curado. Son el resultado, no un predictor.
Los nombres de columna se normalizan «minúsculas, sin acentos, sin símbolos» para trabajar con ellas en código, y se verifican valores nulos explícitamente antes de seguir.
COLUMNAS_RC = ["rc_1_dia_psi", "rc_3_dias_psi", "rc_7_dias_psi", "rc_28_dias_psi"]
COLUMNAS_NO_INFORMATIVAS = ["fecha", "hora", "descripcion"]

print("Columnas de resistencia (las 4, todas resultado del mismo ensayo):")
print(df[COLUMNAS_RC].describe().T[["mean", "std", "min", "max"]])mean std min max rc_1_dia_psi 1931.753507 149.170241 1290.0 2420.0 rc_3_dias_psi 3467.652959 207.313613 2310.0 4180.0 rc_7_dias_psi 4276.728925 231.278619 2820.0 5220.0 rc_28_dias_psi 5163.012422 265.108820 4280.0 6230.0
Punto de adaptación: Este es el primer lugar donde tocarías el código si tu proyecto usa otros datos de control de calidad: cambia DATA_URL por tu propio CSV y COLUMNAS_RC/COLUMNAS_NO_INFORMATIVAS por las columnas equivalentes en tu dataset. El resto del pipeline se ajusta solo.
Checkpoint «Datos»
- El CSV cargó 1,997 filas y 39 columnas, y las 39 quedaron normalizadas a nombres en minúsculas sin acentos
- La celda de configuración imprime las versiones de pandas, numpy y scikit-learn
- Las 4 columnas de resistencia están identificadas y separadas de las 32 variables predictoras
Etapa 2 de 6
Análisis exploratorio
Dos gráficas, cada una responde una pregunta que después condiciona una decisión del pipeline.
¿Qué tan relacionadas están las 4 mediciones de resistencia?
Si las cuatro edades de resistencia están altamente correlacionadas entre sí, es la evidencia directa de que son la misma muestra madurando, no cuatro variables independientes «lo que sustenta la Decisión de la Etapa 3» (Figura 3).
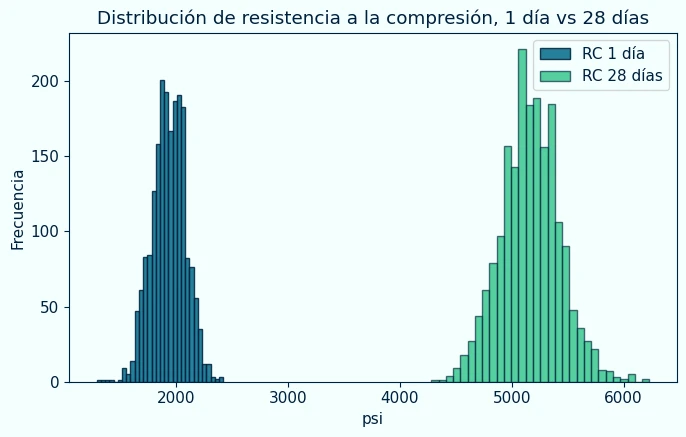
¿Qué tan distinta es la escala entre RC a 1 día y RC a 28 días?
Más allá de estar correlacionadas, las dos edades viven en rangos casi sin traslape (Figura 4): eso es lo que hace que comparar RMSE entre predecir una u otra, sin más contexto, sea engañoso.
El código de ambas gráficas está en el notebook; aquí se muestran solo sus resultados.
Checkpoint «Exploración»
- Confirmaste con números, no solo por intuición, que las 4 columnas de resistencia están correlacionadas y no pueden ser predictoras entre sí
- Sabes que RC 1 día y RC 28 días viven en escalas muy distintas, así que cualquier comparación entre ambas necesita una métrica relativa, no solo RMSE en psi
Etapa 3 de 6
División y definición del objetivo
Antes de entrenar nada se decide cómo se va a dividir y qué se va a predecir. Estas son las dos decisiones que más fácil se rompen sin darse cuenta en datos de producción real.
¿Dividir al azar o por fecha?
Decisión clave
¿Dividir los datos al azar o por fecha?
Estos datos son producción real, con fecha y hora de cada muestra. Un split aleatorio simple puede dejar muestras de un mismo día repartidas entre train y test, y esas muestras consecutivas suelen parecerse entre sí porque vienen del mismo lote de materia prima. El modelo terminaría con una pista que no tendrá en producción: nunca va a predecir la resistencia de un lote que ya vio parcialmente.
Se eligió: ordenar las muestras por fecha y usar el 80% más antiguo como entrenamiento y el 20% más reciente como prueba, para medir qué tan bien generaliza el modelo hacia adelante en el tiempo, que es como se va a usar de verdad.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Dividir los datos al azar o por fecha?
Antes de ver el resultado, contesta esto:
Si un split aleatorio deja muestras del mismo lote de producción en train y en test a la vez, ¿el modelo estaría aprendiendo a predecir, o a reconocer un lote que ya vio parcialmente?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →df["fecha_dt"] = pd.to_datetime(df["fecha"], dayfirst=True, errors="coerce")
assert df["fecha_dt"].isna().sum() == 0, "Hay fechas que no se pudieron interpretar"
df_ordenado = df.sort_values(["fecha_dt", "hora"]).reset_index(drop=True)
corte = int(len(df_ordenado) * 0.8)
idx_train = df_ordenado.index[:corte]
idx_test = df_ordenado.index[corte:]
print(f"Rango de fechas en train: {df_ordenado.loc[idx_train, 'fecha_dt'].min().date()} a {df_ordenado.loc[idx_train, 'fecha_dt'].max().date()}")
print(f"Rango de fechas en test: {df_ordenado.loc[idx_test, 'fecha_dt'].min().date()} a {df_ordenado.loc[idx_test, 'fecha_dt'].max().date()}")
print(f"train: {len(idx_train)} filas | test: {len(idx_test)} filas")Rango de fechas en train: 2019-12-03 a 2021-10-17 Rango de fechas en test: 2021-10-17 a 2022-03-30 train: 1597 filas | test: 400 filas
¿Qué edad de resistencia predecir?
Decisión clave
¿Qué edad de resistencia predecir?
RC a 28 días es la referencia estándar de la industria y la más fácil de predecir, porque el cemento ya terminó casi todo su proceso de curado. RC a 1 día es más ruidosa, pero es la que de verdad sirve como alerta temprana: si algo salió mal en la composición, un control de calidad quiere saberlo al día siguiente, no 28 días después.
Se eligió: predecir RC a 1 día, y excluir las 4 columnas de resistencia del set de variables predictoras, sin importar cuál se use como objetivo, porque ninguna puede ser predictora de las otras.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Qué edad de resistencia predecir: 1 día o 28 días?
Antes de ver el resultado, contesta esto:
Si tu proceso necesita saber si algo salió mal en la mezcla antes de esperar casi un mes de curado, ¿qué variable objetivo tiene más valor operativo, aunque sea más difícil de predecir?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →TARGET = "rc_1_dia_psi"
filas_sin_target = df_ordenado[TARGET].isna()
idx_train = idx_train[~filas_sin_target.loc[idx_train].values]
idx_test = idx_test[~filas_sin_target.loc[idx_test].values]
y = df_ordenado[TARGET]
X = df_ordenado.drop(columns=COLUMNAS_RC + COLUMNAS_NO_INFORMATIVAS + ["fecha_dt"])
X_train, X_test = X.loc[idx_train].copy(), X.loc[idx_test].copy()
y_train, y_test = y.loc[idx_train].copy(), y.loc[idx_test].copy()
print(f"Target: {TARGET}")
print(f"Variables predictoras: {X.shape[1]} (excluidas las 4 columnas de resistencia y las no informativas)")
print(f"train: {X_train.shape} | test: {X_test.shape}")Target: rc_1_dia_psi Variables predictoras: 32 (excluidas las 4 columnas de resistencia y las no informativas) train: (1597, 32) | test: (399, 32)
Punto de adaptación: Si tu dataset tiene varias mediciones relacionadas del mismo resultado «distintas edades, distintas etapas del proceso», este es el lugar para decidir cuál predecir y confirmar, con un assert, que ninguna de las otras se coló entre las predictoras.
Checkpoint «División y objetivo»
- Train va del 3 de diciembre de 2019 al 17 de octubre de 2021; test, del 17 de octubre de 2021 al 30 de marzo de 2022 «1,597 filas de train y 399 de test, tras descartar 1 fila sin target»
- El objetivo es
rc_1_dia_psi, yXtiene 32 columnas: las 39 originales menos las 4 de resistencia y las 3 no informativas
Etapa 4 de 6
Preparación de variables
Datos reales de planta: hay columnas casi constantes y hay huecos de sensor. Ambos se resuelven ajustando solo con entrenamiento, nunca con el dataset completo.
¿Reducir dimensionalidad por varianza o mantener todas las variables?
Decisión clave
¿Reducir dimensionalidad por varianza, o mantener todas las variables?
Varias columnas químicas casi no varían entre muestras «por ejemplo, un óxido menor que la planta mantiene casi constante»: aportan poco y añaden ruido. VarianceThreshold elimina esas columnas de baja varianza.
Se eligió: ajustar el selector solo con X_train. Ajustarlo con el dataset completo, como haría un borrador ingenuo, sería fuga de datos: la decisión de qué columnas conservar terminaría influida por filas que deberían ser desconocidas en el momento de entrenar.
¿Y si tu caso es distinto? Si tu dataset tiene pocas variables para empezar, esta etapa puede no aportar mucho. Con 32 o más variables de composición y de proceso, casi siempre hay algunas casi constantes que vale la pena descartar.
from sklearn.feature_selection import VarianceThreshold

UMBRAL_VARIANZA = 0.05

selector_varianza = VarianceThreshold(threshold=UMBRAL_VARIANZA)
selector_varianza.fit(X_train)

columnas_conservadas = X_train.columns[selector_varianza.get_support()].tolist()
columnas_eliminadas  = [c for c in X_train.columns if c not in columnas_conservadas]

X_train = X_train[columnas_conservadas]
X_test  = X_test[columnas_conservadas]

print(f"Columnas: {X.shape[1]} -> {len(columnas_conservadas)} retenidas")
print(f"Eliminadas por baja varianza: {columnas_eliminadas}")Columnas: 32 -> 20 retenidas Eliminadas por baja varianza: ['arcilla_calcinada', 'al2o3', 'fe2o3', 'so3', 'mgo', 'k2o', 'na2o', 'mn2o3', 'tio2', 'zno', 'cal_libre', 'expansion_en_autoclave']
¿Cómo tratar los valores faltantes?
Error común
Ajustar el imputador o el escalador con el dataset completo, antes de dividir en train y test. Si la mediana o la media que "rellena" o normaliza los datos de prueba está calculada usando también filas de prueba, el modelo tiene información que en producción nunca tendría el día que llegue una muestra nueva. Este proyecto verifica lo contrario de forma explícita: el checklist metodológico compara a mano la mediana de X_train contra la que aprendió el imputador dentro del Pipeline.
Decisión clave
¿Cómo tratar los valores faltantes?
La alternativa más simple sería eliminar filas con algún faltante, pero en datos de planta los huecos no son aleatorios «turnos sin cierta medición, sensores fuera de línea»: tirar esas filas sesgaría el dataset hacia condiciones de operación "completas" y reduciría el tamaño de entrenamiento.
Se eligió: imputación por mediana, ajustada solo con entrenamiento, dentro del mismo Pipeline que el escalado. La mediana es robusta a los atípicos que ya se ven en varias columnas químicas y de resistencia temprana.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Imputar los valores faltantes o eliminar las filas con nulos?
Antes de ver el resultado, contesta esto:
Si los valores faltantes son solo 1 o 2 filas por columna, repartidos al azar entre 32 variables, ¿esperarías que imputar por mediana cambie mucho el resultado frente a simplemente eliminarlas?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Punto de adaptación: Si tu dataset tiene más faltantes que este «17 de 32 columnas, casi todas por debajo del 0.3%», la diferencia entre imputar y eliminar filas deja de ser marginal. Mide ambas rutas antes de asumir cuál conviene.
Checkpoint «Preparación de variables»
- 32 variables se redujeron a 20 con
VarianceThreshold, ajustado solo conX_train - 17 de esas columnas tenían valores faltantes en train, casi todas por debajo del 0.1% de las filas
- La imputación por mediana y el escalado viven dentro del mismo
Pipelineque el modelo, listos para la Etapa 5
Etapa 5 de 6
Modelado y benchmarking
Tres modelos base, comparados con validación cruzada dentro de X_train. El conjunto de prueba se queda completamente afuera hasta la Etapa 6.
¿Qué modelo base usar?
Error común
Reutilizar el mismo split de validación para elegir el modelo y para "confirmar" el RMSE final de la afinación. Un borrador ingenuo compararía los tres modelos con un solo split train/val, y después usaría ese mismo split otra vez para reportar el RMSE de la afinación. Eso reutiliza los mismos datos de evaluación dos veces: para elegir el modelo y para "confirmar" que quedó bien afinado, lo que infla la métrica reportada sin que se note.
Decisión clave
¿Qué modelo base usar?
Random Forest, SVR o KNN, comparados con validación cruzada dentro de X_train, y el conjunto de prueba se queda completamente afuera hasta la evaluación final. Random Forest no necesita las variables escaladas ni imputadas de forma explícita, pero SVR y KNN sí, así que los tres corren dentro del mismo Pipeline «imputación por mediana + escalado», ajustado dentro de cada fold, para que los tres vean exactamente los mismos datos.
Se eligió: Random Forest, el mejor de los tres en validación cruzada.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Qué modelo base usar: Random Forest, SVR o KNN?
Antes de ver el resultado, contesta esto:
Con variables de composición química que interactúan de forma no lineal entre sí, ¿qué tipo de modelo esperarías que capture mejor esas relaciones: uno basado en árboles de decisión, uno basado en distancias entre puntos, o uno basado en un hiperplano de margen máximo?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestRegressor
from sklearn.svm import SVR
from sklearn.neighbors import KNeighborsRegressor
from sklearn.model_selection import cross_val_score
modelos_base = {
"Random Forest": RandomForestRegressor(random_state=SEED),
"SVR": SVR(),
"KNN": KNeighborsRegressor(),
}
def construir_pipeline(modelo):
return Pipeline([
("imputacion", SimpleImputer(strategy="median")),
("escalado", StandardScaler()),
("modelo", modelo),
])
resultados_base = {}
for nombre, modelo in modelos_base.items():
pipe = construir_pipeline(modelo)
rmse_scores = -cross_val_score(pipe, X_train, y_train, cv=cv, scoring="neg_root_mean_squared_error")
resultados_base[nombre] = rmse_scores.mean()
print(f"{nombre:>15}: RMSE = {rmse_scores.mean():.2f} (+/- {rmse_scores.std():.2f})")
mejor_modelo_nombre = min(resultados_base, key=resultados_base.get)
print(f"\nMejor modelo base por RMSE en validación cruzada: {mejor_modelo_nombre}") Random Forest: RMSE = 108.96 (+/- 2.56)
SVR: RMSE = 136.60 (+/- 2.10)
KNN: RMSE = 115.33 (+/- 4.86)
Mejor modelo base por RMSE en validación cruzada: Random Forest
Afinación del mejor modelo
GridSearchCV sobre el modelo ganador, siempre dentro del mismo Pipeline, y siempre sobre X_train.
from sklearn.model_selection import GridSearchCV

grids_por_modelo = {
    "Random Forest": {
        "modelo__n_estimators":      [200, 400],
        "modelo__max_features":      ["sqrt", 1.0],
        "modelo__min_samples_leaf":  [1, 2, 4],
    },
    # SVR y KNN tienen su propia grilla; se omiten aquí porque no ganaron el benchmarking
}

pipeline_mejor = construir_pipeline(modelos_base[mejor_modelo_nombre])
grid_search = GridSearchCV(
    pipeline_mejor, grids_por_modelo[mejor_modelo_nombre],
    cv=cv, scoring="neg_root_mean_squared_error", n_jobs=-1, verbose=1
)
grid_search.fit(X_train, y_train)

mejor_pipeline = grid_search.best_estimator_
print(f"Modelo afinado: {mejor_modelo_nombre}")
print(f"Mejores parámetros: {grid_search.best_params_}")
print(f"Mejor RMSE en validación cruzada: {-grid_search.best_score_:.2f}")Fitting 5 folds for each of 12 candidates, totalling 60 fits
Modelo afinado: Random Forest
Mejores parámetros: {'modelo__max_features': 1.0, 'modelo__min_samples_leaf': 1, 'modelo__n_estimators': 400}
Mejor RMSE en validación cruzada: 108.41
¿Cómo medir la estabilidad del modelo?
Error común
Hacer bootstrap sobre el dataset completo, antes del split, y evaluar cada réplica contra ese mismo dataset completo. Eso significa que el modelo se reentrena y se evalúa sobre filas que se traslapan: gran parte del "test" de cada réplica ya fue parte de su propio entrenamiento, lo que hace que la estabilidad reportada se vea mejor de lo que es en la práctica.
Decisión clave
¿Cómo medir la estabilidad del modelo?
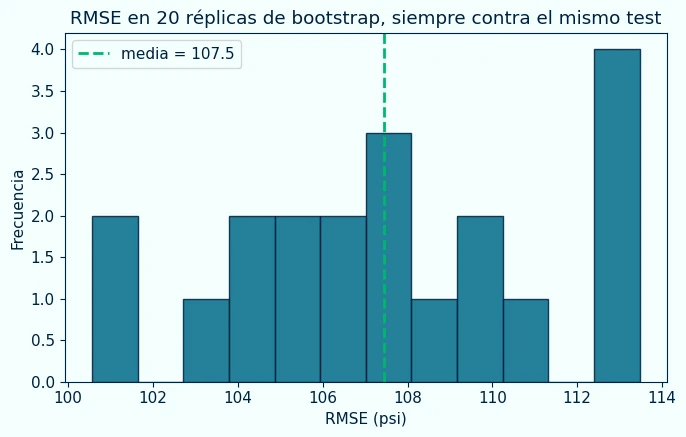
Se eligió: bootstrap, evaluado siempre contra el mismo conjunto de prueba nunca visto. Cada réplica se toma solo de X_train, se reentrena el mismo modelo afinado, y se evalúa siempre contra el mismo X_test, que ninguna réplica tocó nunca para entrenar.
from sklearn.metrics import mean_squared_error
from sklearn.utils import resample
from sklearn.base import clone

N_ITER_BOOTSTRAP = 20
rmse_bootstrap = []

for i in range(N_ITER_BOOTSTRAP):
    X_boot, y_boot = resample(X_train, y_train, random_state=SEED + i)
    modelo_boot = clone(mejor_pipeline)
    modelo_boot.fit(X_boot, y_boot)
    pred_test = modelo_boot.predict(X_test)
    rmse_i = float(np.sqrt(mean_squared_error(y_test, pred_test)))
    rmse_bootstrap.append(rmse_i)

rmse_bootstrap = np.array(rmse_bootstrap)
coef_variacion = float(rmse_bootstrap.std() / rmse_bootstrap.mean())

print(f"RMSE por réplica: min={rmse_bootstrap.min():.2f} | media={rmse_bootstrap.mean():.2f} | max={rmse_bootstrap.max():.2f}")
print(f"Coeficiente de variación del RMSE: {coef_variacion:.4f}")RMSE por réplica: min=100.56 | media=107.46 | max=113.47 Coeficiente de variación del RMSE: 0.0359
Checkpoint «Modelado»
- Random Forest ganó el benchmarking con RMSE de 108.96 psi en validación cruzada, contra 115.33 de KNN y 136.60 de SVR
- La afinación con
GridSearchCVbajó el RMSE de validación cruzada a 108.41 psi, con 400 árboles ymax_features=1.0 - 20 réplicas de bootstrap, siempre contra el mismo test, dan un coeficiente de variación de 0.036: el modelo es estable frente al azar del muestreo de entrenamiento
Etapa 6 de 6
Evaluación final y despliegue
Evaluación final en test
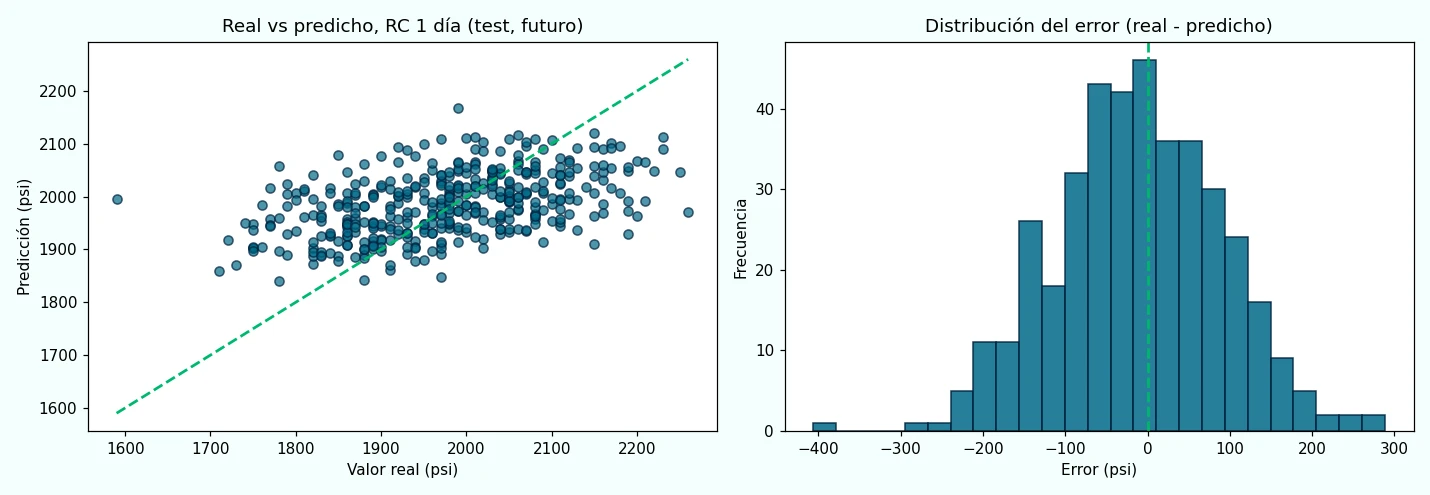
El conjunto de prueba no se ha tocado hasta esta celda: ni en la validación cruzada, ni en la afinación, ni en el test de estabilidad más allá de servir como referencia fija. Esta es la única vez que se usa para reportar el resultado final.
y_pred_test = mejor_pipeline.predict(X_test)
rmse_test = float(np.sqrt(mean_squared_error(y_test, y_pred_test)))
mae_test  = float(np.mean(np.abs(y_test - y_pred_test)))

print(f"RMSE en test (futuro nunca visto): {rmse_test:.2f} psi")
print(f"MAE en test: {mae_test:.2f} psi")RMSE en test (futuro nunca visto): 102.71 psi MAE en test: 81.72 psi
Checklist metodológico, verificado con código
Antes de mostrar cualquier resultado por bueno, ocho aserciones confirman que no hay fuga de datos, que el split respeta el orden temporal y que el target real llegó completo.
# 1. Ninguna columna de resistencia llegó a las variables predictoras
assert not any(c in X_train.columns for c in COLUMNAS_RC)
assert not any(c in X_test.columns for c in COLUMNAS_RC)

# 2. El split respeta el orden temporal: todo train es anterior a todo test
fecha_max_train = df_ordenado.loc[idx_train, "fecha_dt"].max()
fecha_min_test   = df_ordenado.loc[idx_test, "fecha_dt"].min()
assert fecha_max_train <= fecha_min_test

# 4. El imputador y el escalador del pipeline final se ajustaron solo con X_train
mediana_manual   = X_train.median().values
mediana_pipeline = mejor_pipeline.named_steps["imputacion"].statistics_
assert np.allclose(mediana_manual, mediana_pipeline, atol=1e-6)
# ... 5 aserciones más en el notebook completoChecklist metodológico ======================================== 1. Ninguna de las 4 columnas de resistencia llegó a las variables predictoras: OK 2. Todo el train es anterior o igual a todo el test en fecha: OK 3. El VarianceThreshold se ajustó solo con X_train: OK 4. El SimpleImputer y el StandardScaler del pipeline final se ajustaron solo con X_train: OK 5. Las réplicas de bootstrap se entrenaron sobre remuestreos de X_train y se evaluaron siempre contra el mismo X_test: OK 6. Sin overlap de índices entre train y test: OK 7. El SimpleImputer elimina todos los NaN de X_train antes de escalar y modelar: OK 8. Ninguna fila de train o test tiene el target faltante: OK Todas las verificaciones pasaron.
Despliegue como API
El modelo afinado se guarda junto con las columnas y las medianas de cada variable, para poder completar predicciones aunque falte algún dato en la solicitud. Se expone como una API con FastAPI, y se publica temporalmente con ngrok para poder probarla desde el mismo notebook.
Error común
Escribir el token de ngrok directamente en una celda del notebook. Un token así, una vez compartido en cualquier archivo, hay que darlo por comprometido y revocarlo. Este proyecto lo lee de una variable de entorno o de los secretos de Colab, y solo si ninguno existe lo pide de forma interactiva y oculta con getpass, nunca de una cadena de texto en una celda.
from fastapi import FastAPI, HTTPException
import pandas as pd

app = FastAPI(title="FuzzyFrog.AI - API de resistencia a la compresión del cemento", version="1.0")
modelo_api = joblib.load(ruta_modelo)
columnas_api = columnas_conservadas

@app.post("/predict")
def predecir(payload: dict):
    """Recibe un JSON con variables de composición y devuelve la resistencia a 1 día en psi."""
    try:
        fila = pd.DataFrame([payload])
        for col in columnas_api:
            if col not in fila.columns:
                fila[col] = medianas_columnas.get(col, 0.0)
        fila = fila[columnas_api]
        prediccion = float(modelo_api.predict(fila)[0])
        return {"prediccion_rc_1_dia_psi": round(prediccion, 2)}
    except Exception as e:
        raise HTTPException(status_code=500, detail=f"Error en predicción: {e}")
Insight de experto — el pretotipo antes del prototipo. Antes de invertir en una interfaz dedicada, la forma más rápida de saber si un modelo de planta realmente se usa es conectarlo a una herramienta que el ingeniero de planta ya sabe usar. Un pretotipo «un término de Alberto Savoia, distinto de un prototipo» no busca ser bonito ni robusto: busca validar, con la mínima inversión posible, si vale la pena construir la versión real. Aquí, el mismo endpoint /predict se conectó a una función de Google Apps Script en una hoja de cálculo, para poder iterar rápido con datos reales antes de invertir en una API de producción.
function predecirRC1(clinker_conforme, clinker_no_conforme, clinker_total, yeso,
                     caliza, arcilla_calcinada, perdida_ignicion, sio2,
                     fraguado_inicial, fraguado_final, expansion_autoclave, fluidez) {
  // URL del túnel ngrok — cambia cada vez que se reinicia Colab
  const url = "https://xxx.ngrok-free.dev/predict";

  const payload = {
    clinker_conforme, clinker_no_conforme, clinker_total, yeso, caliza,
    arcilla_calcinada, perdida_ignicion, sio2,
    fraguado_inicial, fraguado_final, expansion_autoclave, fluidez
  };

  const options = {
    method: "POST",
    contentType: "application/json",
    payload: JSON.stringify(payload),
    headers: { "ngrok-skip-browser-warning": "true" },
    muteHttpExceptions: true
  };

  try {
    const response = UrlFetchApp.fetch(url, options);
    const data = JSON.parse(response.getContentText());
    if (data && data.prediccion_rc_1_dia_psi) return data.prediccion_rc_1_dia_psi;
  } catch (error) {
    // si la API no responde, el pretotipo no debe romper la hoja de cálculo
  }
}
// Uso en la hoja: =predecirRC1(A2, B2, C2, D2, E2, F2, G2, H2, I2, J2, K2, L2)
Punto de adaptación: El endpoint /predict no cambia si tu interfaz sí. Sustituir la hoja de cálculo por un dashboard, una app móvil o cualquier otro cliente es solo cambiar quién llama a la misma API, no el modelo detrás.
Checkpoint «Evaluación y despliegue»
- RMSE final en test de 102.71 psi y MAE de 81.72 psi, medidos una sola vez, contra datos que el modelo nunca vio
- Las 8 verificaciones del checklist metodológico pasan, con aserciones que corren de verdad
- El modelo quedó desplegado como API real, sin ninguna credencial escrita en el código, y probado con una solicitud real
Sigue: Hallazgos
Hallazgos
Hallazgos principales
- La resistencia a 1 día sí se puede predecir mejor que el promedio, la de 28 días no con este mismo modelo. Con el mismo pipeline y las mismas variables, RC 1 día dio un R² de 0.209 y RC 28 días un R² de −0.073, peor que no hacer nada «Etapa 3».
- Un split aleatorio infla la métrica de forma que no se sostiene. El mismo modelo, sobre el mismo dataset, pasó de un R² real de 0.209 «split temporal» a uno aparente de 0.482 «split aleatorio», sin que el modelo haya mejorado en absoluto.
- Random Forest le ganó a SVR y KNN de forma consistente, tanto en el benchmarking «RMSE 108.96 psi» como en el test de estabilidad «coeficiente de variación de 0.036 en 20 réplicas de bootstrap».
- El modelo comprime hacia el centro. La Figura 6 muestra que subestima los valores altos y sobreestima los bajos: útil como alerta temprana de tendencia, no todavía como reemplazo del ensayo de laboratorio en los extremos del rango.
- Imputar o eliminar filas dio casi el mismo resultado, pero solo porque los faltantes de este dataset son mínimos y dispersos. La imputación sigue siendo la opción a preferir en general, no por el resultado de esta corrida en particular.
Checklist metodológico verificado
Cada punto se verifica con código en el notebook. Si alguno falla, la celda se detiene con un error en vez de dejar pasar un resultado contaminado.
- 8 aserciones sobre fuga de datos, orden temporal y overlap entre train y test, todas con resultado OK.
- 1,597 filas de entrenamiento y 399 de prueba, sin traslape de índices ni de fechas.
- 20 réplicas de bootstrap, todas entrenadas solo sobre remuestreos de train.
Limitaciones y trabajo futuro
El proyecto demuestra el criterio correcto: dividir por fecha, no dejar que una medición relacionada se cuele como predictora, y evaluar la estabilidad sin contaminarla. Sus resultados describen esta planta y este periodo, pero todavía no alcanzan para generalizarlos. Para llevarlo a un sistema que apoye decisiones reales de control de calidad, estos son los frentes a fortalecer, con lo que está reportando la literatura reciente sobre el mismo problema:
- Universo y variables. Validar el mismo pipeline con datos de otra planta o de otra línea de producción, e incorporar variables de proceso que no están en este CSV pero sí existen en planta, como temperatura de horno o humedad ambiental. Un estudio reciente combina precisamente parámetros de mezcla con ensayos no destructivos «esclerómetro y velocidad de pulso ultrasónico» para predecir resistencia temprana con un R² de 0.99 desde los 3 días de curado, ver Rapid on-site prediction of concrete compressive strength using integrated machine learning and non-destructive testing (2026).
- Periodo. Repetir la evaluación con varios cortes temporales, no solo uno, para saber si el desempeño se degrada con el tiempo «drift» conforme cambian los proveedores de materia prima.
- Robustez e interpretabilidad. Calcular intervalos de confianza del RMSE con más réplicas de bootstrap, y complementar la importancia de variables de Random Forest con un análisis SHAP más fino, en la línea de Nikoopayan Tak, Feng & Mahgoub (2025), que usan SHAP para mostrar cómo la edad y la relación agua/cemento contribuyen a cada predicción individual, no solo al promedio.
- Validación externa y despliegue. Comparar sus predicciones contra el juicio de un ingeniero de planta en un periodo piloto, antes de usarlo para decisiones reales; reemplazar ngrok por un despliegue real con autenticación y logging para producción. Trabajos recientes exploran ir más allá del CSV de laboratorio con monitoreo en tiempo real: Palanisamy et al. (2025) integran sensores de temperatura por IoT con redes neuronales para predecir resistencia temprana de forma continua, en vez de solo por muestreo puntual de laboratorio.
Lo que realmente aprendiste
Qué te llevas: cuando tienes varias mediciones del mismo resultado a distintos tiempos, la más fácil de predecir casi nunca es la más útil operativamente. Y un R² que sube al cambiar de split temporal a aleatorio no es una mejora, es una alerta.
Qué repetirías: ajustar cualquier selector, imputador o escalador solo con entrenamiento, dentro de un Pipeline, y verificar con código, no solo con la narrativa, que no hay fuga.
Qué evitarías: asumir que la medición más completa «RC 28 días» es automáticamente la mejor variable objetivo, sin antes preguntar para qué decisión real se va a usar la predicción.
¿Listo para adaptarlo a tu propio caso? La siguiente sección es justo para eso «una guía para identificar qué tocar del código antes de bajarlo y ejecutarlo tú mismo». Ir a Replica este proyecto
Parte 3 de 3
Replica este proyecto
Cómo adaptarlo a tu propio caso. Este sitio no ejecuta código «no hay sandbox ni notebook interactivo». Lo que sí puede darte es claridad total sobre qué parte del pipeline tocar cuando bajes el código y lo corras con tus propios datos de proceso, tu propia variable objetivo o tu propio modelo.
Esta sección reutiliza exactamente las mismas bifurcaciones «"¿Y si tu caso es distinto?"» que ya viste en cada paso «aquí las juntamos para que las apliques a tu proyecto concreto».
Punto por punto: qué hacer con cada decisión clave
Si ya jugaste con el Explorador de decisiones, esto retoma cada una donde la dejaste — con la recomendación puntual para tu propio caso.
¿Dividir los datos al azar o por fecha?
Si tus datos tienen fecha y vienen de un proceso real, ordénalos y divide por fecha, nunca al azar. Un R² más alto con split aleatorio en datos temporales casi siempre es señal de fuga entre lotes, no de un mejor modelo.
¿Qué edad de resistencia predecir: 1 día o 28 días?
Cuando tengas varias mediciones del mismo resultado a distintos tiempos o condiciones, no asumas que la más tardía «la más completa» es la mejor variable objetivo. Pregúntate primero para qué decisión real se va a usar la predicción, y a partir de ahí decide qué tan temprano necesitas el número.
¿Imputar los valores faltantes o eliminar las filas con nulos?
Cuando los faltantes son pocos y dispersos, ambas rutas suelen dar un resultado parecido, como aquí. La imputación dentro del Pipeline sigue siendo la opción a preferir, porque no depende de qué tan pocos sean los huecos: si tu dataset real tiene más, eliminar filas te empieza a costar entrenamiento de verdad.
¿Qué modelo base usar: Random Forest, SVR o KNN?
modelos_base es un diccionario, no una cadena de ifs: agregar un cuarto candidato es una línea nueva ahí, y el resto del benchmarking, la afinación y el bootstrap lo recogen solos porque todos corren dentro del mismo Pipeline.
Qué puedes cambiar sin romper nada
- La fuente de datos «cualquier CSV con composición química y de proceso, más al menos una medición de resultado con fecha, funciona con el mismo código de carga: cambia
DATA_URL». - El umbral de varianza «
UMBRAL_VARIANZAestá en 0.05; súbelo si quieres ser más agresivo eliminando variables casi constantes, o bájalo si tu dataset ya viene con pocas columnas». - La estrategia de imputación «cambiar
strategy="median"por"mean"o"most_frequent"enSimpleImputeres un cambio local, dentro del mismoPipeline». - La proporción del split «
corte = int(len(df_ordenado) * 0.8)define el 80/20; moverlo no afecta la arquitectura del pipeline, mientras se mantenga el orden por fecha». - La grilla de
GridSearchCV«grids_por_modeloes un diccionario por modelo; ampliar los valores a probar no cambia ninguna otra celda».
Qué es más difícil de tocar «y por qué»
- Cambiar la variable objetivo por una que no tiene mediciones relacionadas en el mismo dataset «si tu target no tiene "hermanas" que excluir, la Etapa 3 se simplifica, pero también pierdes la posibilidad de comparar edades como aquí; decide primero qué variable objetivo tiene más valor operativo, como en la Decisión de esa etapa».
- Agregar una familia de modelos que no encaje en
Pipelinede scikit-learn «un modelo de boosting como XGBoost o LightGBM se integra fácil porque exponefit/predict; una red neuronal en TensorFlow o PyTorch necesita su propio ciclo de entrenamiento y ya no comparte el mismocross_val_score». - Cambiar de un split único a validación walk-forward «con más historia y más fechas de decisión, un solo corte 80/20 deja de ser suficiente; pasar a varios cortes móviles no es solo cambiar una línea, cambia cómo se mide la estabilidad y la afinación completas».
Guía de auto-diagnóstico «antes de bajar el código»
Responde esto para ti mismo primero. No es un cuestionario para entregar «es para que sepas, antes de tocar una línea, en qué parte vas a pasar más tiempo».
1. ¿Tu dataset tiene varias mediciones relacionadas del mismo resultado?
Investiga: revisa si alguna columna es, de hecho, otra forma de medir lo mismo que quieres predecir «distintas edades, distintas etapas, distintas unidades del mismo fenómeno». Si la hay, tiene que salir de las variables predictoras.
Señal de que vas bien: puedes explicar en una frase por qué cada variable que dejaste en X es información disponible antes de conocer el resultado, no después.
2. ¿Tus datos tienen fecha y se van a usar hacia adelante en el tiempo?
Investiga: si la respuesta es sí, un split aleatorio va a inflar tu métrica, como viste en la Etapa 3. Ordena por fecha antes de dividir.
Señal de que vas bien: el RMSE con split temporal es peor «no mejor» que con split aleatorio; si es al revés, sospecha de fuga.
3. ¿Qué tan sucios están tus datos de verdad?
Investiga: cuenta valores faltantes por columna, en porcentaje, antes de decidir entre imputar o eliminar filas. Con menos del 1% por columna, ambas rutas dan resultados parecidos; con más, la diferencia empieza a importar.
Señal de que vas bien: puedes justificar tu elección con el porcentaje real de faltantes, no solo por costumbre.
Variantes ya pensadas, por si buscas un punto de partida
- Variante 1 — Predicción multi-salida. En vez de predecir solo RC a 1 día, usa
MultiOutputRegressorde scikit-learn para predecir las 4 edades a la vez «con cuidado de no usar unas como predictoras de otras». Da la curva completa de curado esperada, no solo un punto. - Variante 2 — Otro proceso de control de calidad. El mismo pipeline «división por fecha, selección de variable objetivo entre mediciones relacionadas, reducción dimensional sin fuga, benchmarking» aplica casi sin cambios a cualquier proceso de manufactura con datos de composición o de proceso y una medición de resultado que tarda en obtenerse.
- Variante 3 — Interpretabilidad con SHAP. Random Forest da importancia global de variables; SHAP explica por qué el modelo predijo ese valor para esa muestra específica. Útil para que un ingeniero de planta audite una predicción atípica antes de actuar sobre ella.
Adáptalo con IA
Lo anterior es la vía manual: tú decides qué tocar y lo escribes. Esta es la vía asistida — un prompt ya armado con el contexto del proyecto, las mismas restricciones que evitaron los errores comunes de cada etapa, y los mismos checkpoints como criterios para verificar lo que el modelo te entregue.
CONTEXTO
Voy a adaptar un pipeline de Machine Learning para predecir una propiedad de calidad de un proceso industrial a partir de variables de composición y de proceso, con estas etapas en este orden: (1) carga y limpieza de datos de control de calidad, (2) división de los datos por fecha, entrenando con el pasado y probando contra el futuro, (3) selección de la variable objetivo entre varias mediciones relacionadas del mismo resultado, excluyendo del set de predictoras cualquier otra medición de ese mismo resultado, (4) reducción de variables por varianza, ajustada solo con entrenamiento, (5) benchmarking de varios modelos con validación cruzada y afinación del mejor, (6) test de estabilidad con bootstrap sobre el conjunto de entrenamiento, evaluado siempre contra el mismo conjunto de prueba, y (7) despliegue como API. Voy a correrlo con mis propios datos de proceso, mi propia variable objetivo y, si aplica, mi propio modelo. No cambies el orden de las etapas.

RESTRICCIONES (no las rompas al generar o modificar código)
1. Si los datos tienen fecha, divide por fecha (entrenamiento = pasado, prueba = futuro), nunca al azar. Un split aleatorio en datos de producción real dejará muestras del mismo lote repartidas entre entrenamiento y prueba.
2. Si existen varias mediciones del mismo resultado en distintos momentos o condiciones (por ejemplo, la misma propiedad medida a distintas edades o etapas), ninguna de ellas puede ser predictora de las otras. Exclúyelas todas del set de variables predictoras, se use la que se use como objetivo.
3. Cualquier selección de variables (por varianza, correlación o similar) y cualquier imputación o escalado se ajustan solo con los datos de entrenamiento de cada fold, nunca con el dataset completo antes de dividir.
4. El test de estabilidad por bootstrap se hace remuestreando solo el conjunto de entrenamiento; cada réplica se evalúa siempre contra el mismo conjunto de prueba, que ninguna réplica usó jamás para entrenar.
5. El conjunto de prueba se toca una sola vez, al final, para reportar la métrica definitiva. No se usa para elegir modelo, afinar hiperparámetros ni medir estabilidad.
6. Ninguna credencial (tokens, API keys) se escribe directamente en el código; se lee de variables de entorno o de un gestor de secretos.

CRITERIOS DE ACEPTACIÓN (verifica esto antes de dar el resultado por bueno)
1. Hay un assert que comprueba que ninguna fila de entrenamiento tiene fecha posterior a ninguna fila de prueba.
2. Hay un assert que comprueba que ninguna de las mediciones relacionadas del mismo resultado quedó entre las variables predictoras.
3. Hay un assert que compara a mano la mediana/media usada por el imputador o el escalador contra las de `X_train`, para confirmar que no se ajustaron con datos de prueba.
4. Hay un assert que confirma que no hay overlap de índices entre entrenamiento y prueba.
5. El reporte incluye RMSE y MAE en el conjunto de prueba, el RMSE con su dispersión en validación cruzada, y el coeficiente de variación del RMSE entre réplicas de bootstrap.

Pídeme confirmar cada criterio de aceptación uno por uno antes de continuar a la siguiente etapa.
Si ya conoces la metodología SDD (Constitution/Verify), estas mismas restricciones y criterios son tu Constitution y tu paso de Verify — úsalos ahí en vez del prompt simple de arriba.
Siguiente paso real: abre el notebook y córrelo tal cual, antes de cambiar nada. Ver el resultado base, con sus tablas y su checklist verificado, es lo que te va a dejar claro, con evidencia propia, exactamente dónde necesitas intervenir.
¿Necesitas más ayuda?
¿Tu proyecto requiere análisis de datos o modelos de ML sobre datos de proceso o de producción? Trabajemos juntos.
Quiero información