/ Proyectos / Negocios / Reseñas a tablero de decisión
De reseñas de clientes en varios idiomas a un tablero de decisión estratégica con NLP
Convertir cientos de opiniones dispersas en distintos idiomas en indicadores claros que un equipo directivo pueda usar para decidir, no solo para leer.
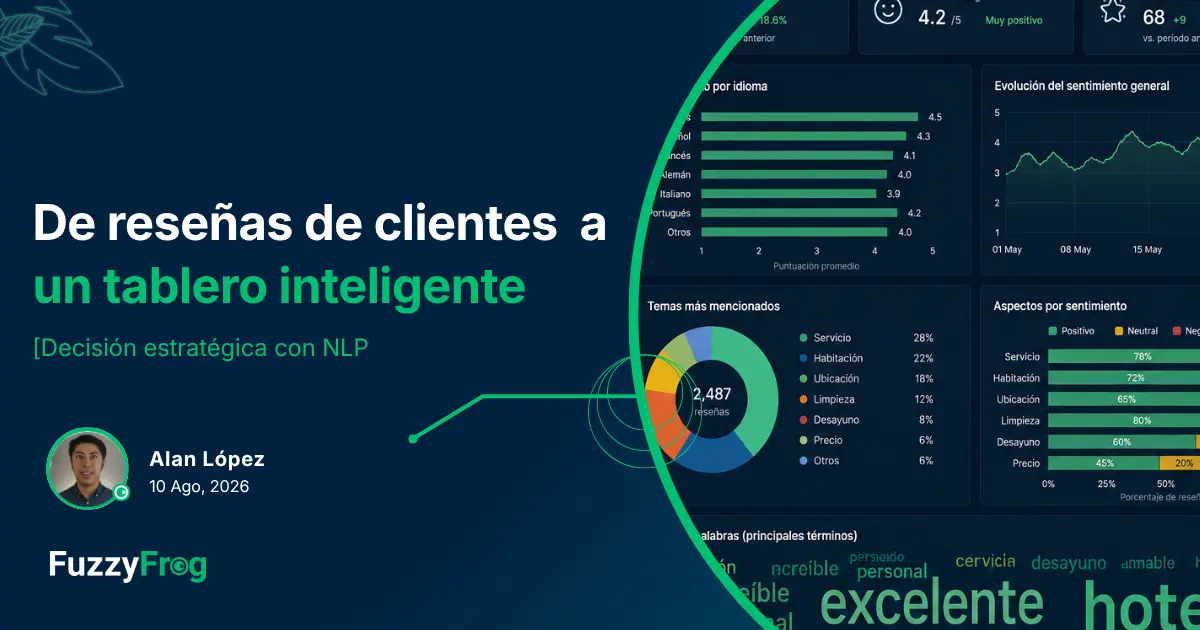
Un negocio con presencia turística acumula reseñas de clientes en varios idiomas, todos los meses, en varias plataformas a la vez. Esa información es valiosa, pero casi nunca llega organizada. El objetivo de este proyecto fue justo ese: tomar esas reseñas dispersas y convertirlas en indicadores concretos que un equipo directivo pueda revisar para tomar decisiones, sin tener que leer cientos de comentarios uno por uno.
El reto no era solo técnico. Requería entender primero qué información generaba el negocio y cuál de esa información realmente aportaba señal útil para decidir. Eso solo se logra manteniendo comunicación constante con quien vive el negocio todos los días, no solo con el dataset.
Mapa del casoContenido
- Diagrama de la solución. El recorrido completo, de la reseña cruda al tablero de decisión
- Construcción de la solución. Por qué cada decisión técnica respondió a una necesidad real del negocio
- Condiciones del proyecto. Restricciones reales y opciones descartadas antes de construir
- Pasos. Qué se dejó al agente y qué criterio se aplicó en cada uno
- Proceso de iteración. Un ajuste real, documentado sin maquillaje
- Descargables. Notebook, diagrama y repositorio del proyecto
- Lecciones importantes. La lección concreta que deja este caso, y cómo se vería hoy
Estructura de alto nivelDiagrama de la solución
Pasa el cursor sobre cada bloque para ver qué hace ese paso.
El pipeline corre en dos ramas paralelas sobre el mismo texto ya limpio. Una mide qué tan positiva o negativa es la conversación. La otra descubre de qué temas habla, sin que nadie le diga cuáles son esos temas de antemano.
De la reseña cruda al indicadorConstrucción de la solución
Condiciones del proyecto
| Restricción | Dato |
|---|---|
| Formato de origen | Exportación de reseñas en Excel, con columnas vacías y encabezados desalineados |
| Idiomas presentes | Varios idiomas dentro del mismo dataset, incluyendo texto sin valor real detectado como idioma por error |
| Etiquetas de sentimiento previas | No existían, el análisis debía construirse sin datos ya etiquetados |
| Prioridad del negocio | Un tablero de indicadores accionable, no solo un reporte descriptivo de opiniones |
| Opción | Por qué se descartó |
|---|---|
| Entrenar un clasificador supervisado de sentimiento desde cero | Habría requerido etiquetar manualmente cientos de reseñas antes de tener un modelo útil, sin presupuesto de tiempo para eso |
| Analizar cada idioma por separado con reglas propias | Multiplicaba el trabajo de mantenimiento sin aportar mejor señal que traducir todo a un idioma común |
| Traducción automática + análisis léxico de sentimiento + clustering no supervisado, validado con el cliente | Aprovecha herramientas ya maduras sin necesitar datos etiquetados, y deja la interpretación de negocio en manos de quien conoce el negocio |
Pasos
Reconstrucción de la estructura del archivo exportado
Agente: propuso pedir que el archivo llegara ya limpio antes de cada análisis.
Criterio aplicado: automatizar la limpieza estructural dentro del propio pipeline, eliminando columnas vacías y recuperando la fila real de encabezados, para que el proceso fuera repetible con cada nueva extracción sin depender de edición manual previa.
Detección de idioma y traducción antes de analizar
Agente: sugirió aplicar el análisis de sentimiento directamente sobre el texto original de cada reseña.
Criterio aplicado: detectar el idioma de cada reseña y traducirla a inglés antes de calcular su polaridad, porque el analizador de sentimiento usado es notablemente más confiable en ese idioma que evaluando texto multiidioma sin normalizar.
Clustering no supervisado en vez de un conteo simple de palabras
Agente: propuso listar las palabras más repetidas de todo el corpus como resumen del contenido.
Criterio aplicado: construir una matriz de frecuencia de términos y aplicar un algoritmo de agrupamiento no supervisado, para descubrir temas que conviven en el dataset y que un conteo global de palabras no distingue.
Validar con el cliente el significado de cada grupo
Agente: pudo asignar de forma automática cada grupo de reseñas a un indicador, basado solo en las palabras más frecuentes del cluster.
Criterio aplicado: presentar los grupos y su sentimiento asociado al equipo del negocio antes de decidir qué indicador representa cada uno, porque el significado de negocio de un patrón encontrado en los datos no es automático.
Proceso de iteración
Ajuste documentado, no forzado
La detección automática de idioma no fue perfecta. Un comentario compuesto por caracteres sin sentido, probablemente ruido de la plataforma de origen, fue clasificado como un idioma poco común dentro del dataset. No había forma de traducirlo ni de analizarlo con criterio, así que se identificó manualmente y se descartó del análisis en lugar de forzar una traducción que no habría significado nada. Es un recordatorio honesto de que la detección automática de idioma falla en textos muy cortos o sin estructura, y que ese tipo de excepciones necesita revisión humana, no una regla más en el código.
CierreLecciones importantes
La parte más importante de este proyecto no ocurrió dentro del notebook. Ocurrió en las conversaciones con el negocio que sirvió como piloto. Un modelo puede etiquetar sentimiento y agrupar temas con precisión técnica, pero decidir qué grupo corresponde a qué indicador de negocio, y qué información realmente sirve para actuar, requiere mantenerse cerca de quien conoce el negocio todos los días. Sin esa validación constante, el proyecto se queda en un ejercicio de datos bien hecho que nadie termina usando para decidir nada.
Si quieres ver un enfoque publicado que combina sentimiento de reseñas con modelos de decisión aplicados a un caso de restaurantes, esta referencia es un buen punto de comparación del tipo de problema: Zuheros, C., Martínez-Cámara, E., Herrera-Viedma, E., y Herrera, F. (2021). Sentiment analysis based multi-person multi-criteria decision making methodology using natural language processing and deep learning for smarter decision aid. Information Fusion, 68, 22-36.
Nota de actualización
Este proyecto se construyó el mismo año en que se lanzó ChatGPT, antes de que existieran modelos de lenguaje con la capacidad actual. El código de este notebook conserva ese enfoque original a propósito, como registro honesto de cómo se resolvió en su momento. Hoy, buena parte de este pipeline se podría simplificar y potenciar bastante: un modelo de lenguaje actual puede leer una reseña en cualquier idioma sin necesidad de traducirla primero, asignarle sentimiento y tema en un solo paso, y hasta sugerir a qué indicador de negocio corresponde, con una calidad de razonamiento muy superior a la de un enfoque léxico o un clustering clásico. La validación humana seguiría siendo necesaria, pero el tramo de ingeniería que hoy toma varios pasos separados podría resolverse con muchas menos piezas.
Termina ya tu proyecto
¿Tienes un proyecto similar y no sabes por dónde empezar? Yo te ayudo a diseñarlo.
El 92% de los profesionales de datos desbloquea sus proyectos al ver ejemplos completos resueltos.
Sin registro. Acceso inmediato