Markowitz con ML para carteras de inversión: LSTM + CAPM + Optimización
Sigue leyendo si vas a construir un pipeline de finanzas cuantitativas « tesis, trabajo o portafolio » y no te basta con copiar código: quieres entender por qué se tomó cada decisión (LSTM vs. medias históricas, mínima volatilidad vs. máximo Sharpe) para poder desarrollar tu propio proyecto.
Parte 1 de 3
Contexto del proyecto
Al terminar, sabrás hacer esto
No son conceptos abstractos. Son decisiones que podrás tomar y justificar en una tesis, en una entrevista o en un proyecto real.
- Pipeline de punta a punta: construyes un flujo completo de finanzas cuantitativas que integra Deep Learning, teoría financiera y optimización numérica, con datos reales de 10 acciones de 2020 a 2024 vía Yahoo Finance.
- Evaluación sin fugas: diseñas un backtest walk-forward con purga y embargo, en el que ningún modelo ni portafolio ve un solo día posterior a la fecha en que tendría que decidir.
- Ingeniería de features: calculas indicadores técnicos desde cero con pandas «SMA, Bandas de Bollinger, RSI y autocorrelación» en forma relativa al precio, para que ninguno crezca sin límite.
- Comparación honesta de modelos: pones a competir LSTM, GRU, Ridge y Gradient Boosting contra la media histórica y el paseo aleatorio, con R² fuera de muestra y coeficiente de información.
- Selección con CAPM: dejas pasar al optimizador solo las acciones cuyo pronóstico supera lo que su riesgo de mercado exige.
- Optimización con Markowitz: estimas la covarianza con Ledoit-Wolf, comparas mínima volatilidad contra máximo Sharpe y entiendes por qué el objetivo decide si tu pronóstico sirve o no.
- Criterio para adaptarlo: identificas en qué punto del pipeline tocar el código si cambian tus datos, tu modelo o tu objetivo, y cómo saber si el cambio realmente mejoró algo.
Modos de uso
- Tesis: replicación crítica de un pipeline LSTM + Markowitz, comparado contra la media histórica, pesos iguales y el S&P 500.
- Trabajo: pipeline walk-forward replicable con cualquier universo de acciones.
- Portafolio: demuestra que sabes evaluar un modelo sin fugas y contra la alternativa simple, no solo entrenarlo.
Prerrequisitos
- Python intermedio: funciones, listas/diccionarios, y haber usado pandas o numpy alguna vez. No necesitas ser experto.
- Nociones de estadística básica: qué es una media, una desviación estándar y una correlación. Se usa constantemente en los tres pilares.
- Cero experiencia previa en LSTM o en finanzas cuantitativas. Eso es justo lo que cubre la siguiente sección.
Brief del proyecto
Un portafolio de inversión es una combinación de distintos activos « acciones, bonos, fondos indexados, etc. » repartidos en ciertas proporciones.
Por ejemplo, para armar un portafolio con $100.00, podrías destinar $30.00 a acciones, $50.00 a bonos, y los $20.00 restantes a un fondo indexado.
Por regla general, un portafolio es mejor que apostarlo todo a una sola opción. Dicho de otra forma: no se trata de elegir un solo activo "ganador", sino de decidir cómo repartir tu dinero entre varios.
Ahí es donde el problema deja de ser trivial: hay que decidir qué porcentaje de tu dinero va a cada activo, y el número de formas posibles de hacer ese reparto crece mucho más rápido de lo que parece.
Un ejemplo para ilustrar el problema. Si tenemos $100.00 a repartir en 4 activos y calculamos las combinaciones posibles en incrementos de $1.00, existen 176,851 formas distintas de hacer ese reparto entre solo cuatro fondos.
Ahora imagínate con 10 fondos « algo común en un portafolio real » el número de combinaciones se cuenta en billones: 4,263,421,511,271 para ser exactos. La Figura 1 muestra qué tan rápido crece.
Combinaciones posibles al repartir $100 según número de activos
Qué está en juego: El rendimiento de tu portafolio. Poner 70% en un activo que cae, y 20% en uno que sube se traduce en un menor rendimiento del esperado, o en pérdidas.
Este es un proyecto demostrativo, no un consejo financiero: hay demasiadas variables en juego para tomarlo como tal.
Para elegir un buen portafolio con buen rendimiento, necesitas responder estas dos preguntas:
- ¿Cómo anticipar qué le espera a cada activo antes de que pase?
- ¿Cómo repartir tu dinero entre todos, sabiendo eso?
La primera parece un trabajo para Machine Learning: patrones que cambian con el tiempo y que un modelo podría aprender por sí mismo. Pero antes de confiar en un modelo hay que comprobar que le gana a la alternativa más simple, que es suponer que el futuro se parece al promedio del pasado. Este proyecto hace justo esa prueba.
La segunda necesita optimización: repartir tu dinero entre fondos tiene millones de combinaciones "correctas", pero ¿Cuál es la óptima que maximiza el rendimiento?
Diagrama de la solución
El pipeline responde dos preguntas en orden, y la respuesta de la primera es el insumo de la segunda (Figura 2).
Datos y fricción real
Antes de tocar el pipeline, esto es lo que realmente te vas a encontrar en los datos de este proyecto — no una advertencia genérica sobre "datos sucios", sino la fricción concreta que después justifica decisiones puntuales más adelante.
- La tasa libre de riesgo no es un número fijo. El T-bill a 13 semanas pasó de −0.10% a 5.35% en el periodo. Suponer un 2% fijo, como hacen muchos tutoriales, habría dejado el umbral de CAPM y el Sharpe muy por debajo de la realidad de 2023 y 2024; por eso el proyecto descarga la tasa del mercado.
- Historial desigual entre activos. Una acción con eventos corporativos (splits, dividendos) tiene saltos que no son movimiento real de precio si no usas el precio ajustado. La descarga pide
auto_adjust=Truede forma explícita, para no depender del valor por defecto de cada versión de yfinance. - Los indicadores técnicos consumen filas al inicio. Con SMA y Bollinger de 20 días, RSI de 14 y autocorrelación móvil de 10, los indicadores pierden 18 filas respecto a usar solo el rendimiento. Con 4 años de historial no es grave; con menos de un año puede dejarte con muy pocas filas útiles (ver la decisión «¿Solo precio de cierre o con indicadores técnicos?» en el Desarrollo).
- yfinance depende de un servicio externo que a veces cambia sin aviso. Cambios en la API no oficial de Yahoo Finance pueden romper una descarga que funcionaba la semana anterior. Si tu descarga falla, primero revisa la versión de
yfinanceantes de asumir que el código tiene un error. - Sesgo de supervivencia. Las 10 acciones se eligieron porque hoy siguen cotizando y crecieron. Eso infla el desempeño de cualquier estrategia, empezando por la más simple: repartir el dinero en partes iguales.
- Lo que este dataset no resuelve. No incluye datos fundamentales ni noticias o sentimiento de mercado: los modelos pronostican solo a partir del precio y de indicadores derivados del precio. Si tu caso necesita esas fuentes, es un cambio de features, no de arquitectura.
Fundamentos teóricos de la solución
Estas cuatro ideas son la base conceptual de todo lo que sigue. Si ya conoces alguno de estos temas, puedes saltarlo.
No hay código aquí a propósito. La idea es que entiendas qué resuelve cada pieza antes de ver cómo se implementa.
En resumen:
- LSTM responde "¿cuánto espero ganar?".
- CAPM responde "¿vale la pena el riesgo de este activo?".
- Markowitz + optimización responden "¿cuánto le pongo a cada uno?".
Con estas cuatro ideas ya tienes el mapa mental completo: lo que sigue es ver cómo se traduce en código.
¿Qué es la Teoría Moderna de Carteras de Markowitz?
La idea central, en una frase: no se trata de elegir los mejores activos individualmente, sino los que combinados reducen el riesgo total. Dos acciones que suben y bajan juntas «alta correlación» no te protegen entre sí; dos que se mueven de forma independiente «baja correlación», sí.
Markowitz formaliza esta intuición en un problema matemático: dado un conjunto de activos, sus rendimientos esperados y cómo se mueven entre sí «la matriz de covarianza», encuentra la combinación de pesos que minimiza el riesgo del portafolio para un nivel de retorno dado. El resultado es la Frontera Eficiente: la curva de todas las combinaciones "óptimas" posibles.
Como ves en el azul claro, hay fondos con más riesgo que rendimiento; en el verde, fondos con más rendimiento que riesgo. Ninguno de los dos extremos es el punto de partida ideal.
El portafolio óptimo, en verde menta sobre la curva, es el que amortigua ambos extremos: busca el mayor rendimiento posible para el menor riesgo posible.
En la práctica, utilizamos un optimizador numérico como SLSQP de SciPy.
¿Qué es CAPM y qué problema resuelve?
Antes de decidir cómo combinar activos «Markowitz», hay que decidir cuáles activos vale la pena considerar. El CAPM «Capital Asset Pricing Model» responde: "dado el riesgo de mercado que trae este activo, ¿su rendimiento esperado lo compensa?".
Cada acción tiene una beta: qué tan sensible es al mercado en general «una beta de 1.5 significa que se mueve 50% más que el mercado». El CAPM usa esa beta para calcular el rendimiento mínimo que deberías exigirle a ese activo.
Si el rendimiento esperado real no alcanza ese mínimo, el activo se descarta antes de llegar a Markowitz.
En verde menta, un activo que queda por arriba de la línea: su rendimiento esperado compensa el riesgo de mercado que trae. En gris, uno que queda por abajo: no lo compensa, y se descarta antes de llegar al optimizador de Markowitz.
¿Qué es una red LSTM y por qué sirve aquí?
Markowitz necesita como insumo el "rendimiento esperado" de cada activo, y ese número hay que estimarlo de algún lado. Una red neuronal normal procesa cada dato de forma aislada.
Una LSTM «Long Short-Term Memory» tiene una especie de "memoria" que le permite recordar patrones de pasos anteriores en una secuencia «útil para series de tiempo, donde lo que pasó la semana pasada puede influir en lo que pasa hoy». Aquí se usa para pronosticar el rendimiento de cada acción en el mes siguiente, como alternativa a la media histórica que usa el Markowitz clásico.
Esa memoria solo sirve si hay algo que recordar. Por eso el proyecto no da por hecho que la LSTM es mejor: la pone a competir contra modelos sin memoria y contra la media histórica, con los mismos datos y las mismas fechas.
Explorador de decisiones
Antes de leer cómo se construyó el pipeline, prueba tú mismo dos de sus decisiones. Es una muestra rápida — las 4 decisiones del proyecto se exploran igual, justo donde aparecen en el desarrollo.
Parte 2 de 3
Desarrollo del proyecto
¿Qué construyes?
Este proyecto integra tres pilares de las finanzas cuantitativas en un solo pipeline: pronóstico de rendimientos con Deep Learning, selección de activos basada en riesgo sistemático y optimización matemática de carteras. Lo que lo distingue es cómo se evalúa: cada pieza se pone a prueba, fuera de muestra, contra la alternativa más simple que existe.
El universo de inversión son 10 acciones de alta capitalización bursátil (AAPL, MSFT, GOOGL, AMZN, TSLA, META, NFLX, NVDA, JPM, JNJ), con datos del 1 de enero de 2020 al 1 de julio de 2024. Desde enero de 2023, cada 21 días hábiles «aproximadamente un mes» el pipeline pronostica el rendimiento del mes siguiente, filtra, optimiza e invierte; después mide qué pasó de verdad.
Esta es la segunda versión del proyecto. La primera pronosticaba precios y se evaluaba con un solo corte de 30 días; en la Etapa 3 verás qué fallaba y por qué la corrección cambió los resultados.
Decisión clave
¿Esto es un problema de regresión o de clasificación?
Pronosticar el rendimiento de una acción es regresión «el objetivo es un valor continuo». Algunos proyectos lo convierten en clasificación (¿sube o baja?), lo cual simplifica pero pierde información clave para Markowitz, que necesita magnitudes, no solo dirección.
Se eligió regresión: el rendimiento pronosticado a 21 días entra directamente como rendimiento esperado al filtro CAPM y al optimizador.
¿Y si tu caso es distinto? Si a ti te piden explícitamente «¿sube o baja?» (por ejemplo, una señal de trading binaria), clasificación puede bastar y es más simple de evaluar. Pero si tu salida alimenta un optimizador como Markowitz, necesitas magnitudes: quédate con regresión.
Insight de experto: La pregunta más importante de todo el pipeline no es técnica «es conceptual: »¿los rendimientos esperados son correctos? Markowitz es tan bueno como los insumos que recibe: si los rendimientos esperados son malos, el portafolio óptimo también lo es. Por eso la pregunta que recorre todo el proyecto es si un modelo de Deep Learning estima esos rendimientos mejor que la media histórica del enfoque clásico.
Arquitectura del pipeline
- Datos: precios ajustados de las 10 acciones, el S&P 500 como mercado y la tasa del T-bill a 13 semanas como tasa libre de riesgo, descargados con
yfinance. - Features y objetivo: rendimiento diario e indicadores técnicos relativos al precio; el objetivo es el rendimiento logarítmico de los 21 días siguientes.
- Pronóstico: seis modelos (LSTM, GRU, Ridge y Gradient Boosting) contra la media histórica y el paseo aleatorio, reentrenados cada trimestre.
- Filtro CAPM: entra al optimizador la acción cuyo pronóstico supera el rendimiento que su beta exige.
- Markowitz y medición: covarianza con Ledoit-Wolf, mínima volatilidad o máximo Sharpe; el portafolio se mantiene 21 días y se mide con rendimientos reales y costos.
El Diagrama de la solución (Figura 2) muestra estas mismas piezas agrupadas por la pregunta que responde cada una.
Stack tecnológico
- Python «lenguaje principal»
- yfinance «descarga de precios, S&P 500 y tasa del T-bill desde Yahoo Finance»
- TensorFlow / Keras «redes LSTM y GRU con Dropout, regularización L2 y paro temprano»
- scikit-learn «StandardScaler, Ridge, HistGradientBoostingRegressor y covarianza Ledoit-Wolf»
- scipy «optimización con minimize (SLSQP) y correlación de rangos de Spearman para el IC»
- pandas / numpy «manipulación de datos y álgebra matricial»
- matplotlib «todas las figuras de resultados»
Probado de principio a fin el 25 de septiembre de 2026 con numpy 2.1.3, pandas 2.2.3, scipy 1.16.3, scikit-learn 1.6.1, TensorFlow 2.20.0 y yfinance 0.2.66.
Etapa 1 de 7
Datos y reproducibilidad
Fija todo el experimento en una sola celda y descarga los datos que el pipeline necesita, incluidos los dos que casi siempre se inventan: el mercado y la tasa libre de riesgo.
El proyecto corre en Google Colab o localmente. En Colab activa un entorno con GPU «Entorno de ejecución → Cambiar tipo de entorno de ejecución»: el backtest entrena 240 redes pequeñas y con GPU tarda alrededor de media hora.
Configuración del experimento
Todas las decisiones numéricas viven en una sola celda, para que cambiarlas no requiera buscar en el resto del notebook. Se fija una semilla y se activa el determinismo de TensorFlow, así dos corridas dan los mismos números, y se imprimen las versiones de cada librería, porque un resultado sin su entorno no se puede reproducir.
# ── Universo y fechas ──
SYMBOLS = ['AAPL', 'MSFT', 'GOOGL', 'AMZN', 'TSLA', 'META', 'NFLX', 'NVDA', 'JPM', 'JNJ']
FECHA_INICIAL   = "2020-01-01"
FECHA_FINAL     = "2024-07-01"
INICIO_BACKTEST = "2023-01-01"   # desde aquí todo es fuera de muestra

# ── Diseño del experimento ──
H              = 21     # horizonte y periodo de tenencia: 21 días hábiles, aprox. un mes
WINDOW         = 20     # días de historia que ve cada modelo por predicción
LOOKBACK_COV   = 252    # un año de rendimientos diarios para covarianza
LOOKBACK_BETA  = 252    # un año de rendimientos diarios para beta
RETRAIN_EVERY  = 3      # los modelos se reentrenan cada 3 rebalanceos, aprox. trimestral
VAL_FRAC       = 0.2    # fracción final del entrenamiento usada como validación interna
EPOCHS_MAX     = 60
PATIENCE       = 8
BATCH_SIZE     = 32
COSTO_TRANSACCION = 0.001   # 10 puntos base por unidad de rotación del portafolio
MIN_ACTIVOS    = 3          # mínimo de activos que deben entrar al optimizador
N_BOOTSTRAP    = 2000
SEED           = 42

tf.keras.utils.set_random_seed(SEED)
try:
    tf.config.experimental.enable_op_determinism()
except Exception as e:
    print("Aviso: no se pudo activar el determinismo de TensorFlow:", e)

print("Ejecutado:", datetime.now().strftime("%Y-%m-%d %H:%M"))
for lib in [np, pd, scipy, sklearn, tf, yf]:
    print(f"{lib.__name__:12s} {lib.__version__}")
print("GPU disponible:", bool(tf.config.list_physical_devices('GPU')))Ejecutado: 2026-09-25 16:18 numpy 2.1.3 pandas 2.2.3 scipy 1.16.3 sklearn 1.6.1 tensorflow 2.20.0 yfinance 0.2.66 GPU disponible: True
Error común
Mezclar versiones de Keras. La API de Keras cambió entre versiones de TensorFlow. Si ves errores como module 'keras' has no attribute 'Sequential', importa desde tensorflow.keras y compara tus versiones con las que imprime esta celda (TensorFlow 2.20.0 en la corrida de referencia).
Descarga de datos con yfinance
Además de las 10 acciones se descargan dos series que el pipeline necesita para no inventar supuestos: el S&P 500 como proxy del mercado para calcular beta, y la tasa del T-bill a 13 semanas como tasa libre de riesgo del periodo. El rango queda fijo, del 1 de enero de 2020 al 1 de julio de 2024, para que el resultado sea reproducible.
def descargar_cierres(tickers, start, end):
    """Descarga precios de cierre ajustados. auto_adjust=True hace que 'Close'
    ya incorpore dividendos y splits, que es el valor por defecto actual de
    yfinance; se declara explícito para que no dependa de la versión."""
    df = yf.download(tickers, start=start, end=end, auto_adjust=True, progress=False)
    close = df['Close']
    if isinstance(close, pd.Series):
        close = close.to_frame(tickers if isinstance(tickers, str) else tickers[0])
    return close

precios_raw = descargar_cierres(SYMBOLS, FECHA_INICIAL, FECHA_FINAL)[SYMBOLS]
sp500_raw   = descargar_cierres('^GSPC', FECHA_INICIAL, FECHA_FINAL).iloc[:, 0]
irx_raw     = descargar_cierres('^IRX',  FECHA_INICIAL, FECHA_FINAL).iloc[:, 0]

# Calendario común: solo días en que cotizan las 10 acciones y el índice.
# La tasa se rellena hacia adelante porque el mercado de bonos cierra en
# algunos feriados en que la bolsa sí abre; nunca se rellena hacia atrás.
idx = precios_raw.dropna().index.intersection(sp500_raw.dropna().index)
precios = precios_raw.loc[idx]
sp500   = sp500_raw.loc[idx].rename('SP500')
irx     = irx_raw.reindex(idx).ffill()

assert precios.notna().all().all(), "Hay precios faltantes en el calendario común"
assert irx.notna().all(), "La tasa libre de riesgo tiene huecos al inicio de la serie"

rf_diaria = (irx / 100.0) / 252          # tasa anual en % convertida a rendimiento diario
ret_simple = precios.pct_change()         # rendimientos simples diarios, para portafolio y CAPM
ret_mkt    = sp500.pct_change()
logp       = np.log(precios)

print(f"Periodo: {idx[0].date()} → {idx[-1].date()}  |  {len(idx)} días hábiles  |  {precios.shape[1]} acciones")
precios.tail(3)Periodo: 2020-01-02 → 2024-06-28 | 1130 días hábiles | 10 acciones
Qué significa cada dato
- Precio de cierre ajustado. El último precio al que se negoció la acción en la sesión, incorporando dividendos y splits, para que un salto por split no se confunda con un movimiento real.
- Rendimiento diario. Cambio porcentual del precio de un día al siguiente. Es la unidad con la que trabajan CAPM y Markowitz.
- Rendimiento logarítmico a 21 días. Lo que se va a pronosticar: cuánto sube o baja la acción en el mes siguiente a la fecha de decisión.
- Tasa libre de riesgo. Rendimiento anual del T-bill a 13 semanas, convertido a diario para restarlo y obtener rendimientos en exceso.
La Tabla 1 resume cada acción en el periodo previo al backtest, que es lo único que un analista habría conocido el 1 de enero de 2023.
pre = ret_simple.loc[:INICIO_BACKTEST].dropna()
resumen = pd.DataFrame({
    'Rend. anual medio': pre.mean() * 252,
    'Volatilidad anual': pre.std() * np.sqrt(252),
    'Peor día': pre.min(),
    'Mejor día': pre.max(),
    'Autocorr. lag 1': pre.apply(lambda s: s.autocorr(1)),
})
print(f"Tasa T-bill: mín {irx.min():.2f}%, máx {irx.max():.2f}%, al inicio del backtest {irx.loc[:INICIO_BACKTEST].iloc[-1]:.2f}%")
resumen.style.format({'Rend. anual medio': '{:.1%}', 'Volatilidad anual': '{:.1%}',
'Peor día': '{:.1%}', 'Mejor día': '{:.1%}', 'Autocorr. lag 1': '{:.3f}'})Tasa T-bill: mín -0.10%, máx 5.35%, al inicio del backtest 4.26%
| Acción | Rend. anual medio | Volatilidad anual | Peor día | Mejor día | Autocorr. lag 1 |
|---|---|---|---|---|---|
| AAPL | 25.8% | 36.9% | −12.9% | 12.0% | −0.151 |
| MSFT | 20.4% | 34.8% | −14.7% | 14.2% | −0.230 |
| GOOGL | 14.4% | 34.5% | −11.6% | 9.2% | −0.148 |
| AMZN | 3.6% | 39.1% | −14.0% | 13.5% | −0.031 |
| TSLA | 74.7% | 72.2% | −21.1% | 19.9% | −0.008 |
| META | −6.3% | 48.7% | −26.4% | 17.6% | −0.067 |
| NFLX | 10.4% | 51.9% | −35.1% | 16.9% | −0.062 |
| NVDA | 45.5% | 56.0% | −18.5% | 17.2% | −0.127 |
| JPM | 8.5% | 37.9% | −15.0% | 18.0% | −0.150 |
| JNJ | 11.3% | 21.8% | −7.3% | 8.0% | −0.166 |
Punto de adaptación: Este es el primer lugar donde tocarías el código si tu proyecto usa otros datos: cambia SYMBOLS por tu propio universo y FECHA_FINAL si quieres datos más recientes. El resto del pipeline se ajusta solo.
Checkpoint «Datos»
- El calendario común tiene 1,130 días hábiles, del 2 de enero de 2020 al 28 de junio de 2024, y los
assertde datos faltantes pasan - La celda de configuración imprime las versiones de numpy, pandas, scipy, scikit-learn, TensorFlow y yfinance
- La tasa del T-bill va de −0.10% a 5.35% y está en 4.26% al inicio del backtest
Etapa 2 de 7
Análisis exploratorio
Tres gráficas, cada una responde una pregunta que después condiciona una decisión del pipeline.
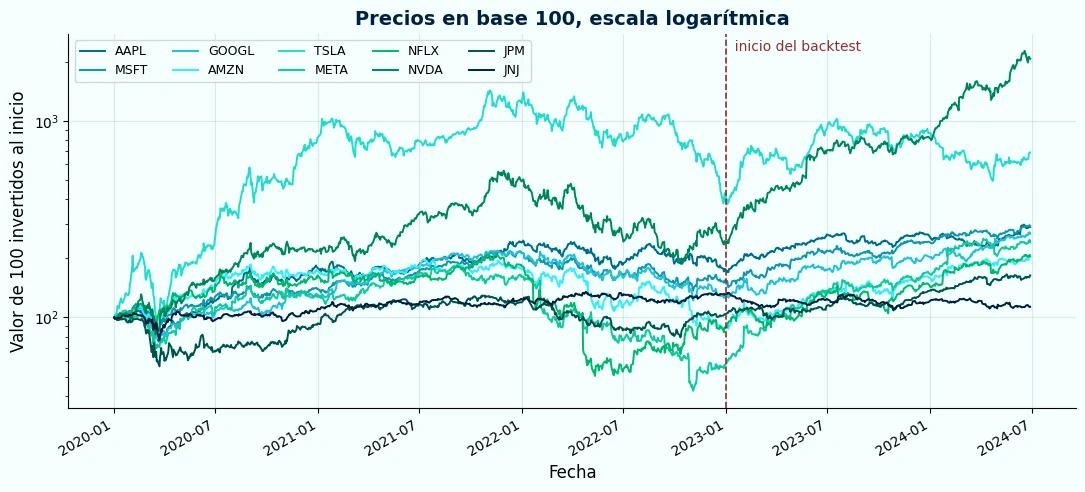
¿Cómo se comparan los activos entre sí?
Los precios en base 100 ponen a las 10 acciones en la misma escala (Figura 5). A la izquierda de la línea punteada está todo lo que un analista conocía el 1 de enero de 2023; a la derecha, el periodo en el que se mide el pipeline.
¿Hay diversificación posible?
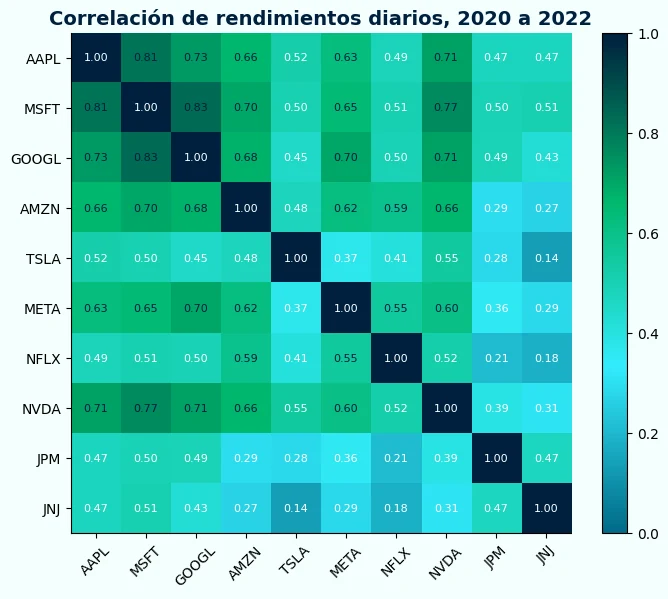
La matriz de correlación es el insumo central de Markowitz (Figura 6): correlaciones bajas significan que combinar activos reduce el riesgo.
¿Hay algo que pronosticar?
Si la autocorrelación de los rendimientos diarios es casi cero, ningún modelo va a sacar mucha señal del precio pasado, y la vara con la que se mida cualquier modelo tiene que ser una alternativa simple (Figura 7).
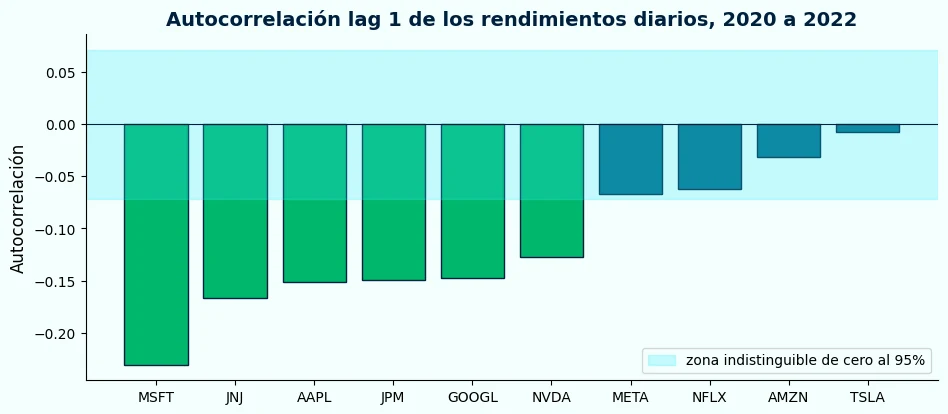
Lo que dice la Figura 7 marca todo lo que sigue: la memoria de corto plazo de los rendimientos es débil y, en varias acciones, indistinguible de cero. Por eso cada modelo de este proyecto se compara contra dos alternativas que no aprenden nada: la media histórica, que es el insumo clásico de Markowitz, y el paseo aleatorio, que pronostica rendimiento cero. Si un modelo no les gana a esas dos, su complejidad no se justifica.
El código de las tres gráficas está en el notebook; aquí se muestran solo sus resultados.
Checkpoint «Exploración»
- Identificas qué acciones tienen correlación baja con el resto (JNJ y JPM) y por qué importan para Markowitz
- Sabes qué acciones tienen autocorrelación distinguible de cero y cuáles no
- Tienes claras las dos vallas que cualquier modelo tiene que superar: la media histórica y el paseo aleatorio
Etapa 3 de 7
Diseño de la evaluación
Antes de entrenar nada se decide cómo se va a medir. Esta etapa existe porque la primera versión de este proyecto se midió mal.
Lo que falló en la primera versión
La primera versión pronosticaba el nivel del precio y calculaba el rendimiento esperado con las predicciones de los mismos 30 días de prueba. Tenía dos problemas que no se veían en las métricas. Se dejan documentados porque son el tipo de error que más se repite en proyectos como este.
Error común
Pronosticar el nivel del precio con un escalado MinMax. El escalado se ajusta con el entrenamiento. Cuando el precio de prueba supera el máximo histórico, la red no sabe extrapolar y su predicción se queda plana: en NVDA quedó en unos 88 dólares mientras el precio real subía de 94 a 135.
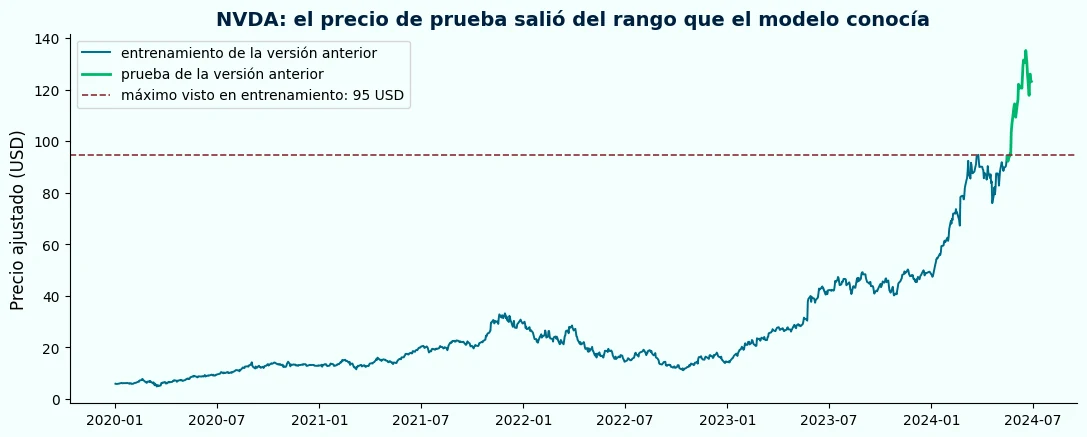
El segundo problema es más difícil de ver: cada predicción de un día usaba los precios reales de los días anteriores del mismo periodo de prueba, así que el «rendimiento esperado» del mes ya contenía casi todo el mes. Ese número no lo habría tenido nadie el día en que tenía que invertir.
La corrección es la base de esta versión: se pronostica el rendimiento a 21 días, que no tiene tendencia y se mantiene en rango, y se pronostica desde la fecha de decisión hacia adelante, con datos que solo llegan hasta ese día. En rendimientos, el periodo de prueba de NVDA (de −0.069 a 0.089 diario) cabe de sobra dentro del rango de entrenamiento (de −0.204 a 0.218).
Walk-forward con purga
Decisión clave
¿Evaluar con un solo corte de prueba o con walk-forward?
Un solo corte: más simple y rápido, pero mide un solo mes y es fácil que información del periodo de prueba se filtre al entrenamiento.
Walk-forward: muchas fechas de decisión, cada una con información solo hasta ese día, a cambio de más código y más cómputo.
Se eligió: walk-forward con purga y embargo, porque es la única forma de simular lo que un analista habría podido hacer en cada fecha.
¿Y si tu caso es distinto? Si solo quieres comparar arquitecturas rápido, un corte único sirve como primera exploración, pero no para reportar resultados: cualquier número que publiques debe salir de una evaluación que respete el tiempo.
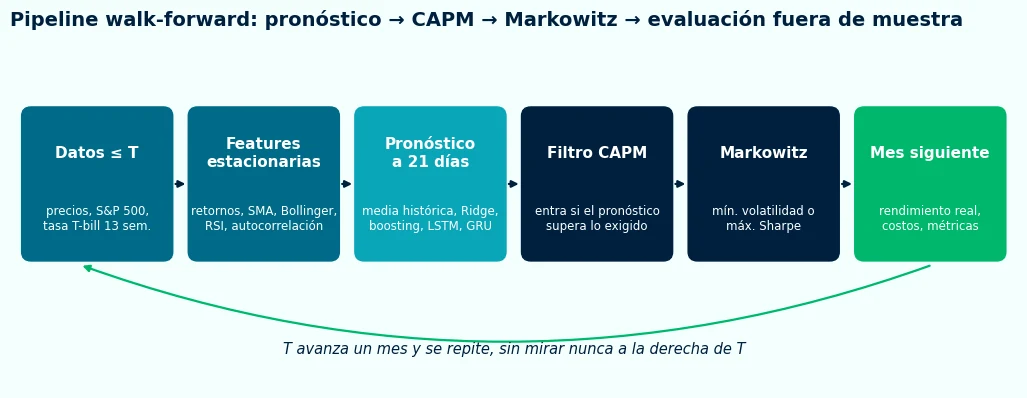
- Fechas de decisión. Desde enero de 2023, una cada 21 días hábiles. En cada una se pronostica, se filtra, se optimiza y se invierte por los 21 días siguientes.
- Purga. El objetivo de un día es el rendimiento de los 21 días siguientes. Una muestra solo entra al entrenamiento si esos 21 días ya terminaron antes de T; sin esto, el modelo entrenaría con rendimientos que todavía no ocurrieron.
- Embargo en la validación. La validación interna, que decide cuándo detener el entrenamiento, es el último 20% del periodo de entrenamiento, separado por 21 días para que ningún objetivo se traslape entre las dos partes. El periodo de prueba nunca se usa para validar.
- Reentrenamiento trimestral. Los modelos se reentrenan cada tres fechas de decisión. Entre reentrenamientos se usa el último modelo con los datos nuevos de entrada, que es lo que haría un analista en la práctica.
La Figura 9 muestra ese ciclo en el tiempo. Es la misma cadena del Diagrama de la solución (Figura 2), pero repetida mes a mes.
p_inicio = idx.searchsorted(pd.Timestamp(INICIO_BACKTEST))
REBAL = list(range(p_inicio, len(idx) - H, H))           # posiciones de las fechas de decisión
RETRAIN = REBAL[::RETRAIN_EVERY]                         # posiciones donde se reentrena

assert REBAL[0] - max(LOOKBACK_COV, LOOKBACK_BETA) >= 1, "No hay historia suficiente antes del backtest"
assert all(p + H <= len(idx) - 1 for p in REBAL), "Algún periodo de tenencia se sale de los datos"

print(f"{len(REBAL)} fechas de decisión: {idx[REBAL[0]].date()} a {idx[REBAL[-1]].date()}")
print(f"{len(RETRAIN)} reentrenamientos por modelo y por acción")
print(f"Periodo fuera de muestra evaluado: {idx[REBAL[0] + 1].date()} a {idx[REBAL[-1] + H].date()}")17 fechas de decisión: 2023-01-03 a 2024-05-06 6 reentrenamientos por modelo y por acción Periodo fuera de muestra evaluado: 2023-01-04 a 2024-06-05
Checkpoint «Evaluación»
- 17 fechas de decisión, del 3 de enero de 2023 al 6 de mayo de 2024, con un periodo fuera de muestra que termina el 5 de junio de 2024
- 6 reentrenamientos por modelo y por acción
- Ningún objetivo usado en entrenamiento termina después de T, y ninguno del ajuste se traslapa con la validación
Sigue: Etapa 4 · Features
Etapa 4 de 7
Features
Convierte el precio en información que un modelo pueda usar sin extrapolar.
Decisión clave
¿Solo precio de cierre o con indicadores técnicos?
Solo precio: más simple y con menos riesgo de sobreajuste, pero pierde señales de momentum y volatilidad.
Con indicadores: más contexto para el modelo, a cambio de más features que calcular y más filas perdidas por las ventanas móviles.
Se eligió: indicadores técnicos, como en la versión original del proyecto. Esta vez las dos opciones se corren de verdad, con el mismo modelo y las mismas fechas.
¿Y si tu caso es distinto? Con menos de un año de historial, agregar indicadores es justo la opción que más riesgo corre de dejarte con muy pocas filas útiles para entrenar, porque cada ventana móvil consume filas al principio de la serie.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Solo precio de cierre o con indicadores técnicos?
Antes de ver el resultado, contesta esto:
La autocorrelación de los rendimientos es casi cero (lo verás en la Figura 7). Con tan poca señal, ¿qué esperas que pase al darle al modelo cinco features más?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Features estacionarias
Para que las dos opciones sean comparables, el precio entra como rendimiento diario y los indicadores se expresan en forma relativa al precio. Así ninguna feature crece sin límite, como lo hacía el precio en la versión anterior:
- SMA de 20 días, como distancia del precio a su promedio:
precio / SMA − 1. - Bandas de Bollinger de 20 días y 2 desviaciones, como posición dentro de las bandas «%B» y como ancho relativo de las bandas.
- RSI de 14 días, escalado de 0 a 1.
- Autocorrelación de rezago 1 en ventana móvil de 10 días, calculada sobre los rendimientos, un valor por día.
El objetivo es el rendimiento logarítmico de t a t+21. En el día t todavía no se conoce: solo existe en t+21, y por eso la purga lo respeta.
FEATS_PRECIO = ['ret_1']
FEATS_IND    = ['ret_1', 'sma_ratio', 'bb_pctb', 'bb_width', 'rsi_14', 'autocorr_10']

def calcular_features(close):
    """Todas las ventanas miran solo hacia atrás: el valor del día t usa
    datos hasta t. Por eso se pueden calcular sobre la serie completa sin
    filtrar el futuro, y el checklist final lo comprueba recalculando sobre
    series recortadas."""
    f = pd.DataFrame(index=close.index)
    r = np.log(close).diff()
    f['ret_1'] = r
    sma = close.rolling(20).mean()
    std = close.rolling(20).std()
    upper, lower = sma + 2 * std, sma - 2 * std
    f['sma_ratio'] = close / sma - 1
    f['bb_pctb']   = (close - lower) / (upper - lower)
    f['bb_width']  = (upper - lower) / sma
    delta = close.diff()
    gain = delta.clip(lower=0).rolling(14).mean()
    loss = (-delta.clip(upper=0)).rolling(14).mean()
    f['rsi_14'] = (100 - 100 / (1 + gain / loss)) / 100
    f['autocorr_10'] = r.rolling(10).apply(lambda s: pd.Series(s).autocorr(lag=1), raw=True)
    return f.replace([np.inf, -np.inf], np.nan)

def calcular_objetivo(close, h=H):
    """Rendimiento logarítmico de t a t+h. En el día t todavía no se conoce:
    solo existe en t+h, y por eso la purga del entrenamiento lo respeta."""
    lc = np.log(close)
    return lc.shift(-h) - lc

FEATURES = {s: calcular_features(precios[s]) for s in SYMBOLS}
OBJETIVO = {s: calcular_objetivo(precios[s]) for s in SYMBOLS}

primer_valido_precio = FEATURES['AAPL'][FEATS_PRECIO].dropna().index[0]
primer_valido_ind    = FEATURES['AAPL'][FEATS_IND].dropna().index[0]
print("Primer día utilizable, solo precio:  ", primer_valido_precio.date())
print("Primer día utilizable, con indicadores:", primer_valido_ind.date())
print("Filas perdidas por las ventanas móviles:",
      FEATURES['AAPL'].index.get_loc(primer_valido_ind) - FEATURES['AAPL'].index.get_loc(primer_valido_precio))
FEATURES['AAPL'][FEATS_IND].describe().T[['mean', 'std', 'min', 'max']]Primer día utilizable, solo precio: 2020-01-03
Primer día utilizable, con indicadores: 2020-01-30
Filas perdidas por las ventanas móviles: 18
mean std min max
ret_1 0.000939 0.020581 -0.137708 0.113157
sma_ratio 0.009131 0.046420 -0.168029 0.147493
bb_pctb 0.575826 0.327447 -0.260390 1.370145
bb_width 0.128782 0.058040 0.032976 0.362568
rsi_14 0.545923 0.170513 0.031798 0.932418
autocorr_10 -0.122656 0.292054 -0.930479 0.867402
La salida confirma dos cosas: con indicadores pierdes 18 filas al inicio de cada serie, y todas las features viven en rangos acotados, sin la tendencia que tenía el precio.
Checkpoint «Features»
- Recalcular los indicadores con la serie recortada en T da exactamente el mismo valor en T que calcularlos con la serie completa: ninguno mira el futuro
- Con indicadores, el primer día utilizable es el 30 de enero de 2020, 18 filas después que solo con el rendimiento
- El objetivo coincide con el rendimiento logarítmico a 21 días recalculado desde los precios
Etapa 5 de 7
Modelos y pronóstico
Pon a competir seis modelos, con la misma información, contra dos alternativas que no aprenden nada.
Decisión clave
¿Cuántas capas LSTM y cuántas unidades?
Una sola capa de 50 unidades: entrena más rápido y es menos propensa a sobreajustar, pero puede no capturar patrones complejos.
Tres capas apiladas con Dropout: más capacidad de representación, a costa de más tiempo de entrenamiento y más riesgo de memorizar ruido.
Se eligió: tres capas de 50 unidades con Dropout de 0.2 y 0.1 y salida con regularización L2, la arquitectura original del proyecto. Para saber si la profundidad aporta, la comparación de abajo aísla una variable a la vez.
¿Y si tu caso es distinto? Si quieres probar otra arquitectura, por ejemplo un Transformer de series de tiempo, construir_rnn es la única pieza que reemplazas: el resto del pipeline no se entera, porque solo espera un rendimiento esperado por activo.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Cuántas capas LSTM y cuántas unidades?
Antes de ver el resultado, contesta esto:
Si un modelo lineal con la misma ventana de 20 días ordena las acciones casi igual de bien, ¿qué te dice eso sobre lo que aporta la memoria de la red?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Modelos candidatos
- LSTM de 3 capas: la arquitectura original del proyecto.
- LSTM de 1 capa: cambia solo la profundidad.
- GRU de 3 capas: cambia solo el tipo de celda. La GRU tiene menos parámetros que la LSTM y suele entrenar más rápido con resultados parecidos.
- Ridge y Gradient Boosting: reciben exactamente la misma ventana de 20 días, aplanada. Si una red recurrente no le gana a un modelo lineal con la misma información, la memoria de la red no está aportando.
- LSTM de 3 capas solo con precio: la otra opción de la decisión de features.
- Media histórica y paseo aleatorio: las dos vallas mínimas de la Etapa 2.
def construir_rnn(tipo):
    """Sin input_shape: Keras construye el modelo con la forma del primer lote."""
    if tipo == 'LSTM-3':
        capas = [LSTM(50, return_sequences=True), LSTM(50, return_sequences=True), Dropout(0.2),
                 LSTM(50), Dropout(0.1), Dense(1, kernel_regularizer=L2(0.01))]
    elif tipo == 'LSTM-1':
        capas = [LSTM(50), Dropout(0.2), Dense(1, kernel_regularizer=L2(0.01))]
    elif tipo == 'GRU-3':
        capas = [GRU(50, return_sequences=True), GRU(50, return_sequences=True), Dropout(0.2),
                 GRU(50), Dropout(0.1), Dense(1, kernel_regularizer=L2(0.01))]
    else:
        raise ValueError(tipo)
    model = Sequential(capas)
    model.compile(optimizer='adam', loss='mean_squared_error')
    return model

# nombre visible → (familia, arquitectura, features)
MODELOS = {
    'Ridge':                 ('tabular', 'ridge',  FEATS_IND),
    'Gradient Boosting':     ('tabular', 'hgb',    FEATS_IND),
    'LSTM 1 capa':           ('rnn',     'LSTM-1', FEATS_IND),
    'LSTM 3 capas':          ('rnn',     'LSTM-3', FEATS_IND),
    'GRU 3 capas':           ('rnn',     'GRU-3',  FEATS_IND),
    'LSTM 3 capas, solo precio': ('rnn', 'LSTM-3', FEATS_PRECIO),
}
BASELINES = ['Media histórica', 'Paseo aleatorio']
MODELO_PROYECTO = 'LSTM 3 capas'   # la elección original del artículo

n_rnn = sum(1 for v in MODELOS.values() if v[0] == 'rnn')
print(f"Redes a entrenar: {n_rnn} arquitecturas × {len(SYMBOLS)} acciones × {len(RETRAIN)} reentrenamientos = {n_rnn * len(SYMBOLS) * len(RETRAIN)}")Redes a entrenar: 4 arquitecturas × 10 acciones × 6 reentrenamientos = 240
Entrenamiento sin fugas
Cada modelo se entrena con información disponible hasta la fecha de decisión T y solo pronostica de T en adelante. La función aplica la purga, separa la validación con un embargo de 21 días y ajusta el escalado únicamente con las filas del ajuste. Las redes se detienen cuando la validación deja de mejorar y conservan los pesos de su mejor época; en Ridge y Gradient Boosting, la regularización y el número de árboles también se eligen con esa validación temporal, nunca con una partición aleatoria.
def entrenar_y_predecir(nombre, activo, p_T, pred_pos, guardar_historia=False):
    """Entrena con información disponible hasta p_T y pronostica en pred_pos (todas ≥ p_T)."""
    familia, arq, cols = MODELOS[nombre]
    F = FEATURES[activo][cols].values.astype(float)
    y = OBJETIVO[activo].values.astype(float)
    valid = ventanas_validas(F, WINDOW)

    # Purga: el objetivo de t termina en t+H y tiene que haber ocurrido a más tardar en T.
    pos_train = [t for t in range(len(F)) if valid[t] and t + H <= p_T and not np.isnan(y[t])]
    n_val = int(len(pos_train) * VAL_FRAC)
    pos_val = pos_train[-n_val:]
    pos_fit = [t for t in pos_train[:-n_val] if t + H < pos_val[0]]   # embargo de H días

    # Escalado ajustado solo con las filas que entran al ajuste del modelo.
    fin_scaler = pos_fit[-1]
    filas_fit = F[:fin_scaler + 1][~np.isnan(F[:fin_scaler + 1]).any(axis=1)]
    scaler = StandardScaler().fit(filas_fit)
    assert np.allclose(scaler.mean_, filas_fit.mean(axis=0)), "El scaler no corresponde a las filas de entrenamiento"
    Fs = np.where(np.isnan(F), np.nan, (F - scaler.mean_) / scaler.scale_)
    y_mu, y_sd = y[pos_fit].mean(), y[pos_fit].std()

    X_fit, X_val = armar_X(Fs, pos_fit, WINDOW), armar_X(Fs, pos_val, WINDOW)
    X_pred = armar_X(Fs, pred_pos, WINDOW)
    assert not np.isnan(X_pred).any(), f"Ventana de pronóstico incompleta para {activo}"
    yz_fit, yz_val = (y[pos_fit] - y_mu) / y_sd, (y[pos_val] - y_mu) / y_sd
Error común
Ajustar el escalado con todo el dataset. Si el scaler ve el periodo de validación o de prueba, el modelo aprende de valores que en producción todavía no existirían (data leakage). Aquí se ajusta solo con las filas del ajuste, y un assert comprueba que sus medias coinciden con esas filas.
Un modelo de muestra antes del backtest completo
Antes de entrenar los 240 modelos, uno de prueba: el LSTM de 3 capas para AAPL en la primera fecha de decisión, solo con datos anteriores a enero de 2023. La Figura 10 compara la pérdida de entrenamiento contra la de validación interna; el periodo de prueba no participa.
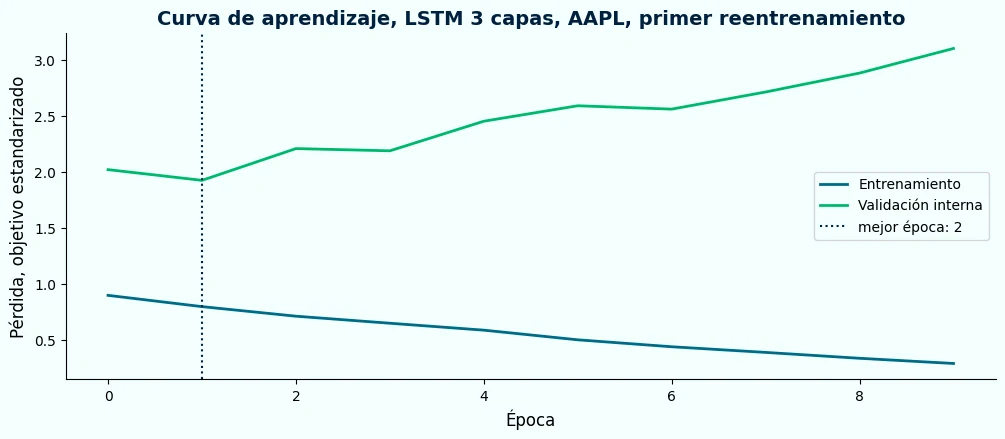
Si la validación deja de bajar en las primeras épocas no es un error del código: es la señal honesta de que hay poca estructura que aprender en el precio pasado, lo mismo que anticipaba la Figura 7. El pronóstico de esta red de muestra para AAPL, a 21 días desde el 3 de enero de 2023, fue de +0.50%.
Backtest de pronósticos
Cada modelo produce un pronóstico por acción en cada fecha de decisión, con el modelo del último reentrenamiento anterior o igual a esa fecha. Los resultados se guardan en disco: si vuelves a correr el notebook con la misma configuración, esta celda los carga en vez de entrenar todo otra vez.
CONFIG = dict(SYMBOLS=SYMBOLS, FECHA_INICIAL=FECHA_INICIAL, FECHA_FINAL=FECHA_FINAL, INICIO_BACKTEST=INICIO_BACKTEST,
              H=H, WINDOW=WINDOW, RETRAIN_EVERY=RETRAIN_EVERY, VAL_FRAC=VAL_FRAC, EPOCHS_MAX=EPOCHS_MAX,
              PATIENCE=PATIENCE, BATCH_SIZE=BATCH_SIZE, SEED=SEED, MODELOS=list(MODELOS), n_dias=len(idx))
CACHE = f"pronosticos_{hashlib.md5(json.dumps(CONFIG, sort_keys=True).encode()).hexdigest()[:10]}.pkl"

def bloques_de_prediccion():
    """Asigna a cada reentrenamiento las fechas de decisión que le tocan."""
    for k, p_T in enumerate(RETRAIN):
        siguiente = RETRAIN[k + 1] if k + 1 < len(RETRAIN) else len(idx)
        yield p_T, [p for p in REBAL if p_T <= p < siguiente]

if os.path.exists(CACHE):
    with open(CACHE, 'rb') as fh:
        PRONOSTICOS, LOG_ENTRENAMIENTO = pickle.load(fh)
    print("Pronósticos cargados de", CACHE)
else:
    filas = []
    t_inicio = time.time()
    for nombre in MODELOS:
        t_modelo = time.time()
        for activo in SYMBOLS:
            for p_T, pred_pos in bloques_de_prediccion():
                preds = entrenar_y_predecir(nombre, activo, p_T, pred_pos)
                for p, yhat in zip(pred_pos, preds):
                    filas.append((idx[p], activo, nombre, float(yhat)))
        print(f"{nombre:28s} listo en {(time.time() - t_modelo) / 60:5.1f} min")
    PRONOSTICOS = pd.DataFrame(filas, columns=['fecha', 'activo', 'modelo', 'pred'])
    with open(CACHE, 'wb') as fh:
        pickle.dump((PRONOSTICOS, LOG_ENTRENAMIENTO), fh)
    print(f"Total: {(time.time() - t_inicio) / 60:.1f} min. Guardado en {CACHE}")

# Baselines: no se entrenan, se calculan con datos hasta T.
lr_diario = logp.diff()
filas = []
for p in REBAL:
    for activo in SYMBOLS:
        media = lr_diario[activo].iloc[p - LOOKBACK_COV + 1:p + 1].mean() * H
        filas.append((idx[p], activo, 'Media histórica', float(media)))
        filas.append((idx[p], activo, 'Paseo aleatorio', 0.0))
PRONOSTICOS = pd.concat([PRONOSTICOS, pd.DataFrame(filas, columns=PRONOSTICOS.columns)], ignore_index=True)

# Rendimiento real a 21 días, solo para evaluar, nunca como insumo.
PRONOSTICOS['real'] = [OBJETIVO[a].loc[f] for a, f in zip(PRONOSTICOS['activo'], PRONOSTICOS['fecha'])]
assert PRONOSTICOS['real'].notna().all()

# Tabla fecha × acción por modelo, para consultar rápido el pronóstico de una fecha.
PRED = {m: g.pivot(index='fecha', columns='activo', values='pred')[SYMBOLS] for m, g in PRONOSTICOS.groupby('modelo')}
def mu_de(modelo, p):
    """Rendimiento esperado simple a 21 días de cada acción, pronosticado en la fecha p."""
    return np.expm1(PRED[modelo].loc[idx[p]])

PRONOSTICOS.head()Ridge listo en 0.0 min Gradient Boosting listo en 0.5 min LSTM 1 capa listo en 4.5 min LSTM 3 capas listo en 7.4 min GRU 3 capas listo en 8.1 min LSTM 3 capas, solo precio listo en 9.6 min Total: 30.1 min. Guardado en pronosticos_f391c179fe.pkl
¿Qué modelo pronostica mejor?
Decisión clave
¿Con qué métrica decides qué modelo es mejor?
Error de pronóstico (MAE, RMSE): fácil de leer, pero no dice si el modelo le gana a no hacer nada ni si ordena bien las acciones.
Métricas relativas: R² fuera de muestra contra el paseo aleatorio e IC, que miden si el modelo aporta algo sobre la alternativa simple.
Se eligió: cuatro métricas de pronóstico, porque cada una responde algo distinto, y una segunda capa de negocio en la Etapa 7: el Sharpe del portafolio, fuera de muestra y con costos. Son para audiencias distintas.
¿Y si tu caso es distinto? Si tu pronóstico alimenta un optimizador de portafolio, el IC suele importar más que el MAE: no hace falta acertar el número exacto, hace falta ordenar bien qué acción va a rendir más.
- MAE: error absoluto medio del rendimiento a 21 días. Es la más fácil de leer.
- R² fuera de muestra contra paseo aleatorio:
1 − error del modelo / error de pronosticar cero. Es la métrica estándar en la literatura de predicción de rendimientos; un valor negativo significa que pronosticar cero habría sido mejor. - Acierto de dirección: qué tan seguido el modelo acierta si la acción sube o baja.
- IC, coeficiente de información: correlación de rangos entre pronóstico y resultado entre las 10 acciones de cada fecha. Es la que más le importa a un portafolio.
def metricas_pronostico(df):
    err = df['pred'] - df['real']
    sse0 = (df['real'] ** 2).sum()
    ic_fecha = df.groupby('fecha').apply(
        lambda g: spearmanr(g['pred'], g['real'])[0] if g['pred'].nunique() > 1 else np.nan)
    return pd.Series({
        'MAE': err.abs().mean(),
        'R² vs paseo aleatorio': 1 - (err ** 2).sum() / sse0,
        'Acierto de dirección': (np.sign(df['pred']) == np.sign(df['real'])).mean() if df['pred'].abs().sum() > 0 else np.nan,
        'IC medio': ic_fecha.mean(),
        'IC t-stat': ic_fecha.mean() / ic_fecha.std() * np.sqrt(ic_fecha.notna().sum()) if ic_fecha.notna().sum() > 2 else np.nan,
    })

ORDEN = BASELINES + list(MODELOS)
MET_PRON = PRONOSTICOS.groupby('modelo').apply(metricas_pronostico).loc[ORDEN]
seg = pd.DataFrame(LOG_ENTRENAMIENTO).groupby('modelo')['segundos'].sum()
MET_PRON['Minutos de entrenamiento'] = [seg.get(m, 0) / 60 for m in MET_PRON.index]
MET_PRON.style.format({'MAE': '{:.2%}', 'R² vs paseo aleatorio': '{:+.3f}', 'Acierto de dirección': '{:.1%}',
'IC medio': '{:+.3f}', 'IC t-stat': '{:+.2f}', 'Minutos de entrenamiento': '{:.1f}'}, na_rep='—')| Modelo | MAE | R² | Dirección | IC | t del IC | Minutos |
|---|---|---|---|---|---|---|
| Media histórica | 8.35% | −0.098 | 54.7% | +0.065 | +0.57 | 0.0 |
| Paseo aleatorio | 8.35% | +0.000 | — | — | — | 0.0 |
| Ridge | 8.39% | +0.013 | 55.9% | +0.072 | +0.95 | 0.0 |
| Gradient Boosting | 8.13% | +0.064 | 60.0% | −0.065 | −1.13 | 0.5 |
| LSTM 1 capa | 8.53% | +0.052 | 54.1% | +0.034 | +0.42 | 4.5 |
| LSTM 3 capas | 8.81% | −0.046 | 55.3% | −0.010 | −0.11 | 7.4 |
| GRU 3 capas | 8.81% | +0.028 | 54.1% | −0.000 | −0.00 | 8.1 |
| LSTM 3 capas, solo precio | 8.09% | +0.155 | 55.3% | +0.077 | +0.97 | 9.6 |
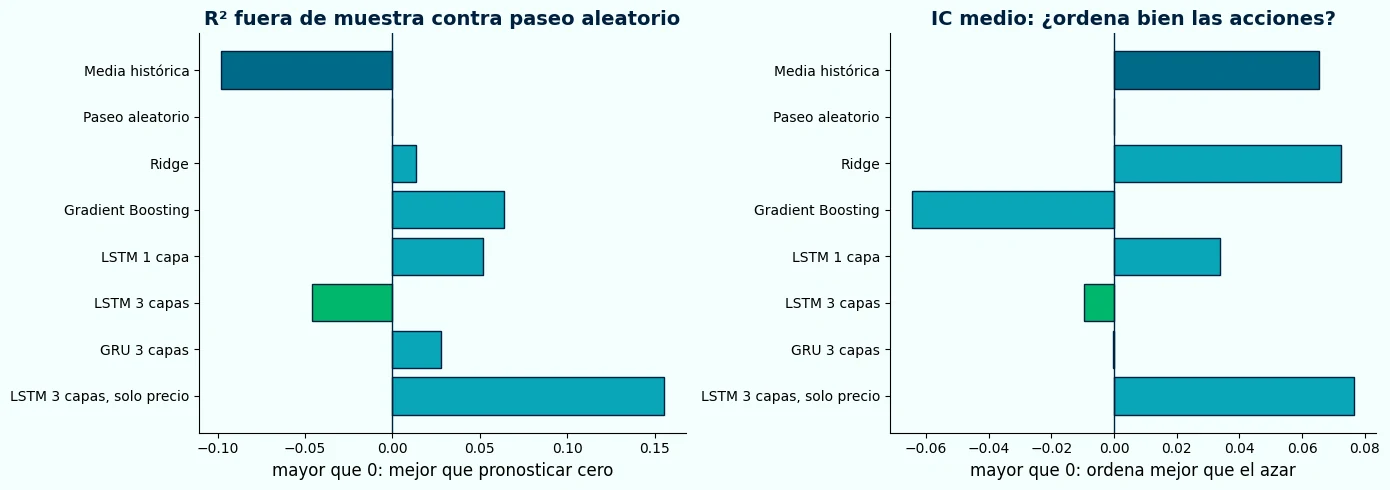
Las dos decisiones del modelo se leen directo de la Tabla 2 y la Figura 11: sin indicadores, el mismo LSTM pasó de −0.046 a +0.155 de R²; con una sola capa, a +0.052. Ridge, sin ninguna memoria, ordena las acciones (IC de +0.072) casi igual que el mejor modelo. Cinco de los seis modelos le ganan al paseo aleatorio en R², pero ninguno ordena las acciones con un IC distinguible del azar: el estadístico t más alto es 0.97.
Checkpoint «Pronóstico»
- Cada scaler se ajustó con filas anteriores a la validación y a T: 360 entrenamientos auditados
- Todo pronóstico se hizo en una fecha igual o posterior al reentrenamiento que lo produjo
- Cada modelo tiene 17 × 10 pronósticos, y comparaste todos contra la media histórica y el paseo aleatorio antes de elegir
Etapa 6 de 7
Selección de activos con CAPM
Deja pasar al optimizador solo las acciones cuyo pronóstico paga lo que su riesgo exige.
El Modelo de Valoración de Activos de Capital (CAPM) dice cuánto rendimiento hay que exigirle a una acción por el riesgo de mercado que trae: rendimiento exigido = tasa libre de riesgo + beta × prima de mercado. La regla de filtro compara ese mínimo contra lo que el modelo pronostica: una acción entra al optimizador solo si su rendimiento pronosticado supera su rendimiento exigido, es decir, si tiene alfa positivo. Todo se mide en el mismo horizonte de 21 días, y beta, tasa y prima se calculan con datos hasta T.
Decisión clave
¿Incluir todos los activos en Markowitz o filtrar antes con CAPM?
Todos los activos: Markowitz puede asignar peso cero a los malos por sí solo, pero el optimizador se vuelve más sensible a errores de estimación.
Filtrar con CAPM: reduce el universo a activos con premio por riesgo justificado según el pronóstico.
Se eligió: filtrar primero, como en la versión original. Aquí se corren las dos opciones, con el mismo modelo y el mismo objetivo.
¿Y si tu caso es distinto? Si tu universo ya tiene menos de 10 activos, pregúntate qué tan justificado sigue estando el filtro. Y sin un benchmark de mercado claro, por ejemplo con cripto o activos alternativos, este es el primer paso que hay que repensar.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Incluir todos los activos en Markowitz o filtrar antes con CAPM?
Antes de ver el resultado, contesta esto:
El portafolio de mínima volatilidad solo depende de la covarianza. Sin filtro, ¿por dónde entraría el pronóstico del modelo?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Si menos de 3 acciones pasan, entran las 3 de mayor alfa, para que siempre haya algo que diversificar. En el backtest pasó en el 18% de las fechas de decisión.
LOG_PORTAFOLIO = []

def capm_en(p):
    """Beta, tasa y prima de mercado con datos hasta la posición p, en horizonte H."""
    v = slice(p - LOOKBACK_BETA + 1, p + 1)
    rf_v = rf_diaria.iloc[v]
    ex_m = ret_mkt.iloc[v] - rf_v
    betas = pd.Series({s: np.cov(ret_simple[s].iloc[v] - rf_v, ex_m)[0, 1] / ex_m.var() for s in SYMBOLS})
    prima_diaria = (ret_mkt.iloc[1:p + 1] - rf_diaria.iloc[1:p + 1]).mean()   # toda la historia hasta T
    rf_H = rf_diaria.iloc[p] * H
    exigido = rf_H + betas * prima_diaria * H
    return betas, exigido, rf_H, ret_mkt.index[v][-1]

def filtro_capm(mu, exigido):
    alfa = mu - exigido
    sel = alfa[alfa > 0].index.tolist()
    forzado = len(sel) < MIN_ACTIVOS
    if forzado:
        sel = alfa.sort_values(ascending=False).index[:MIN_ACTIVOS].tolist()
    return [s for s in SYMBOLS if s in sel], forzado

betas0, exigido0, rf0, _ = capm_en(REBAL[0])
print(f"Ejemplo en {idx[REBAL[0]].date()}: tasa libre de riesgo a 21 días = {rf0:.2%}")
pd.DataFrame({'beta': betas0, 'exigido a 21 días': exigido0}).style.format({'beta': '{:.2f}', 'exigido a 21 días': '{:.2%}'})Ejemplo en 2023-01-03: tasa libre de riesgo a 21 días = 0.35%
| Acción | Beta | Exigido a 21 días |
|---|---|---|
| AAPL | 1.31 | 1.21% |
| MSFT | 1.28 | 1.19% |
| GOOGL | 1.34 | 1.23% |
| AMZN | 1.64 | 1.42% |
| TSLA | 1.76 | 1.50% |
| META | 1.74 | 1.49% |
| NFLX | 1.66 | 1.43% |
| NVDA | 2.21 | 1.79% |
| JPM | 0.88 | 0.93% |
| JNJ | 0.30 | 0.55% |
Error común
Usar una tasa libre de riesgo fija. Con un 2% fijo, en 2023 el umbral de CAPM habría quedado muy por debajo de la tasa real del mercado, que al inicio del backtest era de 4.26% anual, y el filtro dejaría pasar acciones que no pagaban ni lo que un bono sin riesgo. Descarga la tasa del periodo y exprésala en el mismo horizonte que el pronóstico.
Punto de adaptación: Si tu universo no tiene un índice de mercado claro contra el cual calcular beta (por ejemplo, activos alternativos o criptomonedas), este es el paso que necesitas repensar primero «no lo asumas, decide qué benchmark usarás antes de avanzar a Markowitz».
Checkpoint «CAPM»
- Toda beta se calcula con un año de datos que termina en T
- La tasa libre de riesgo es la del T-bill del periodo, en el mismo horizonte de 21 días: 0.35% en la primera fecha
- Sabes en qué porcentaje de fechas pasaron menos de 3 acciones: 18%
Etapa 7 de 7
Markowitz y backtest de portafolios
Reparte el dinero entre las acciones que pasaron el filtro y mide, mes a mes y con costos, qué habría pasado.
- Covarianza con Ledoit-Wolf. Con 252 días y hasta 10 acciones, la covarianza muestral es ruidosa. Ledoit-Wolf la encoge hacia una estructura más estable y es la práctica estándar para no sobreajustar el optimizador.
- Todo en el mismo horizonte. Rendimientos esperados, covarianza y tasa libre de riesgo se expresan a 21 días. Mezclar volatilidad diaria con rendimiento mensual haría que cualquier Sharpe no tuviera sentido.
- Solo posiciones largas. Pesos entre 0 y 1 que suman 1.
Decisión clave
¿Minimizar volatilidad o maximizar el ratio de Sharpe?
Mínima volatilidad: más conservador y numéricamente más estable; es el punto más a la izquierda de la Frontera Eficiente.
Máximo Sharpe: busca el mejor balance entre retorno y riesgo, pero es más sensible a errores en los rendimientos esperados.
Se eligió: mínima volatilidad, como en la versión original. Aquí se corren las dos, más pesos iguales como referencia.
¿Y si tu caso es distinto? Si tus rendimientos esperados vinieran de guía oficial de la empresa en lugar de una predicción, valdría la pena reconsiderar el objetivo. Cambiarlo es un ajuste local dentro de la llamada a scipy.optimize.minimize.
Explorador de decisiones — prueba tú esta alternativa 2 min
¿Minimizar volatilidad o maximizar el ratio de Sharpe?
Antes de ver el resultado, contesta esto:
Si tu pronóstico tiene un R² negativo, ¿cuál de los dos objetivos le da más peso a ese error al repartir el dinero?
Qué hubiera pasado con esa alternativa
Ver cómo adaptar esta decisión a tu caso →Insight de experto: un detalle que cambia la lectura de todo el proyecto. El portafolio de mínima volatilidad depende solo de la covarianza, no de los rendimientos esperados. Si el optimizador minimiza volatilidad sobre todas las acciones, el pronóstico del modelo no mueve ni un peso. El pronóstico solo influye si decide qué acciones entran, que es lo que hace el filtro CAPM, o si el objetivo lo usa, que es lo que hace el máximo Sharpe. La verificación de abajo lo comprueba con dos pronósticos distintos.
def cov_en(p, activos):
    v = slice(p - LOOKBACK_COV + 1, p + 1)
    R = ret_simple[activos].iloc[v]
    assert R.index[-1] == idx[p] and R.notna().all().all()
    return LedoitWolf().fit(R.values).covariance_ * H

def _resolver(fun, n):
    cons = ({'type': 'eq', 'fun': lambda w: np.sum(w) - 1},)
    mejor = None
    for w0 in [np.repeat(1 / n, n), np.random.default_rng(SEED).dirichlet(np.ones(n))]:
        r = minimize(fun, w0, method='SLSQP', bounds=[(0, 1)] * n, constraints=cons,
                     options={'ftol': 1e-12, 'maxiter': 1000})
        if r.success and (mejor is None or r.fun < mejor.fun):
            mejor = r
    assert mejor is not None, "El optimizador no convergió"
    w = np.clip(mejor.x, 0, None)
    return w / w.sum()

def min_vol(S):
    return _resolver(lambda w: w @ S @ w, len(S))

def max_sharpe(mu, S, rf):
    if np.max(mu) <= rf:
        return min_vol(S), True          # ningún activo supera la tasa: Sharpe máximo no está definido
    return _resolver(lambda w: -(w @ mu - rf) / np.sqrt(w @ S @ w), len(S)), False

# Verificación de la lección: mínima volatilidad sin filtro ignora el pronóstico.
p_chk = REBAL[0]
S_chk = cov_en(p_chk, SYMBOLS)
w_mv_chk = min_vol(S_chk)   # min_vol solo recibe la covarianza: no hay dónde meter un pronóstico
ws_a, _ = max_sharpe(mu_de(MODELO_PROYECTO, p_chk).values, S_chk, rf_diaria.iloc[p_chk] * H)
ws_b, _ = max_sharpe(mu_de('Media histórica', p_chk).values, S_chk, rf_diaria.iloc[p_chk] * H)
print("Mínima volatilidad: mismos pesos con cualquier pronóstico, porque solo depende de la covarianza")
print("   ", dict(zip(SYMBOLS, np.round(w_mv_chk, 3))))
print("Máximo Sharpe con pronóstico LSTM vs media histórica: diferencia total de pesos =", round(float(np.abs(ws_a - ws_b).sum()), 3))Mínima volatilidad: mismos pesos con cualquier pronóstico, porque solo depende de la covarianza
{'AAPL': np.float64(0.0), 'MSFT': np.float64(0.043), 'GOOGL': np.float64(0.024), 'AMZN': np.float64(0.0), 'TSLA': np.float64(0.011), 'META': np.float64(0.0), 'NFLX': np.float64(0.0), 'NVDA': np.float64(0.0), 'JPM': np.float64(0.153), 'JNJ': np.float64(0.769)}
Máximo Sharpe con pronóstico LSTM vs media histórica: diferencia total de pesos = 2.0
La Frontera Eficiente con el pronóstico del modelo
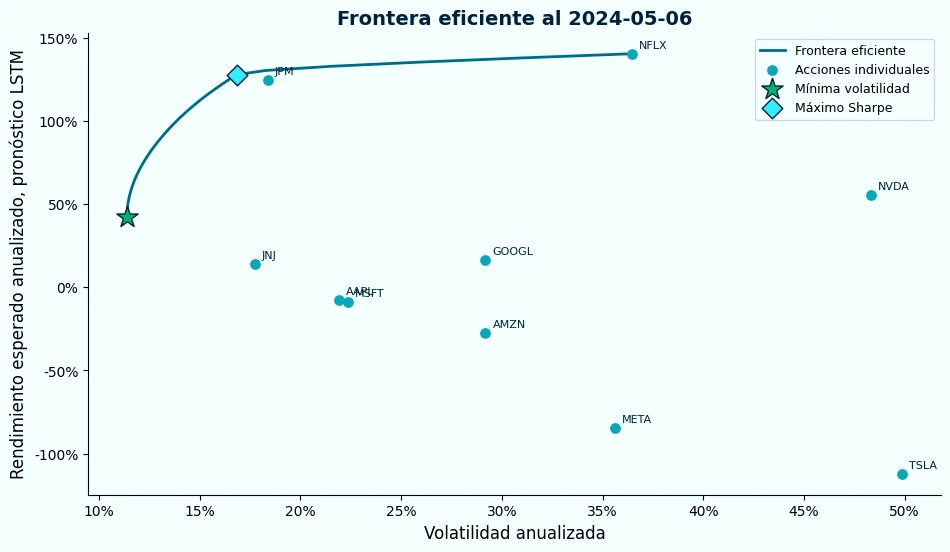
La Figura 12 muestra la frontera en la última fecha de decisión, con los rendimientos que pronosticó el LSTM de 3 capas. Es la versión con datos reales de la Figura 3.
Backtest de portafolios
Cada estrategia se construye en cada fecha de decisión con la información disponible ese día, se mantiene 21 días y se mide con el rendimiento real de esos días.
- Referencias que no usan pronóstico: S&P 500, pesos iguales y mínima volatilidad sobre las 10 acciones.
- Por cada modelo de pronóstico: filtro CAPM + mínima volatilidad, que es el pipeline original del proyecto; máximo Sharpe sin filtro, y filtro CAPM + máximo Sharpe.
- Costos: cada rebalanceo paga 10 puntos base por unidad de rotación. Una estrategia que cambia todo cada mes paga más.
- Métricas: rendimiento y volatilidad anualizados, Sharpe en exceso de la tasa libre de riesgo con su intervalo de confianza, caída máxima, rotación y número de activos con peso.
def correr_backtest(estrategia, modelo=None):
    diarios, rotaciones, n_activos, max_peso = [], [], [], []
    w_prev = pd.Series(0.0, index=SYMBOLS)
    for p in REBAL:
        w, info = pesos_estrategia(estrategia, modelo, p)
        assert abs(w.sum() - 1) < 1e-6 and (w >= -1e-9).all(), "Pesos inválidos"
        R = ret_simple.iloc[p + 1:p + H + 1]              # el periodo de tenencia empieza después de T
        assert R.index[0] > idx[p]
        crecimiento = (1 + R).cumprod()
        valor = (crecimiento * w).sum(axis=1)
        r = valor.pct_change()
        r.iloc[0] = valor.iloc[0] - 1
        rot = float((w - w_prev).abs().sum())
        r.iloc[0] -= COSTO_TRANSACCION * rot
        diarios.append(r)
        rotaciones.append(rot); n_activos.append(int((w > 1e-4).sum())); max_peso.append(float(w.max()))
        w_prev = (w * crecimiento.iloc[-1]) / (w * crecimiento.iloc[-1]).sum()   # pesos a la deriva al cierre
        LOG_PORTAFOLIO.append({'estrategia': estrategia, 'modelo': modelo, 'p': p,
                               'fin_beta': info.get('fin_beta'), 'inicio_tenencia': R.index[0],
                               'forzado': info.get('forzado', False),
                               'sharpe_indefinido': info.get('sharpe_indefinido', False),
                               'pesos': w.round(4).to_dict()})
    serie = pd.concat(diarios)
return serie, dict(rotacion=np.mean(rotaciones[1:]), n_activos=np.mean(n_activos), max_peso=np.mean(max_peso))24 estrategias evaluadas sobre 357 días fuera de muestra
Error común
Evaluar el portafolio con los mismos datos con los que se optimizó. Si optimizas y evalúas sobre el mismo periodo, los resultados son ilusoriamente buenos. Aquí cada periodo de tenencia empieza el día después de T, y un assert lo comprueba en cada una de las 17 fechas.
| Estrategia | Rend. anual | Volat. anual | Sharpe | IC 95% del Sharpe | Caída máx. | P(> pesos iguales) | Activos |
|---|---|---|---|---|---|---|---|
| Pesos iguales | 78.5% | 20.2% | 2.72 | 1.20 a 4.41 | −11.2% | — | 10.0 |
| S&P 500 | 26.8% | 12.6% | 1.55 | 0.01 a 3.22 | −10.3% | 1% | — |
| LSTM 3 capas, solo precioCAPM + máx. Sharpe | 128.4% | 37.0% | 2.28 | 0.32 a 4.18 | −21.3% | 23% | 2.6 |
| LSTM 3 capasCAPM + máx. Sharpe | 66.4% | 34.3% | 1.50 | −0.54 a 3.27 | −27.4% | 2% | 2.2 |
| LSTM 3 capasCAPM + mín. volatilidad | 24.4% | 18.2% | 1.01 | −0.55 a 2.55 | −19.6% | 0% | 3.3 |
| Media históricaCAPM + mín. volatilidad | 19.1% | 14.8% | 0.91 | −0.84 a 2.75 | −13.7% | 2% | 4.1 |
| Mín. volatilidad, 10 acciones | 7.0% | 12.6% | 0.19 | −1.62 a 2.01 | −13.7% | 0% | 6.2 |
El intervalo del Sharpe es ancho a propósito: 18 meses son pocos para separar habilidad de suerte. La columna P(> pesos iguales), la probabilidad de que el Sharpe de la estrategia supere al de pesos iguales, resume lo mismo en un número; 50% significaría que, con esta muestra, una estrategia no se distingue de repartir el dinero en partes iguales.
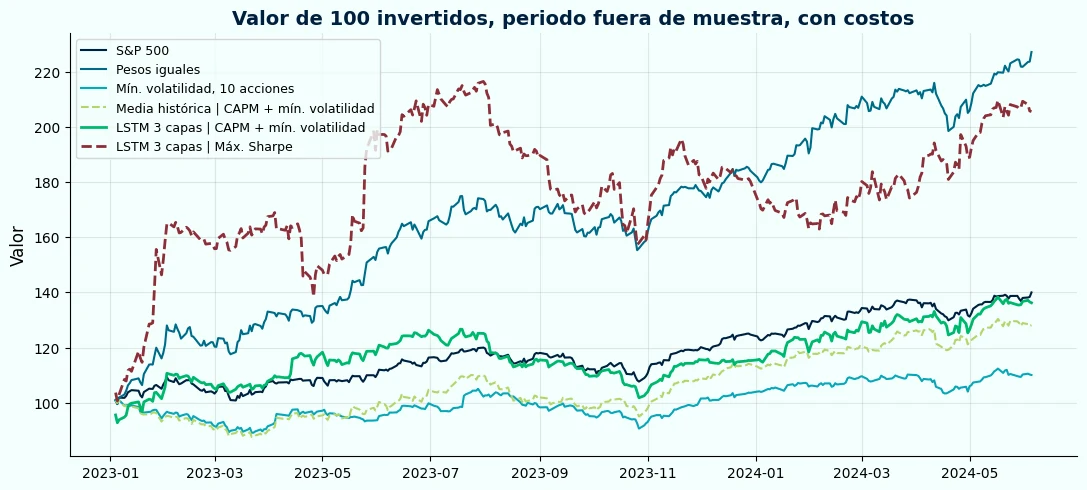
Las dos decisiones del portafolio se leen de la Tabla 4: el filtro CAPM subió el Sharpe de 0.19 a 1.01, porque es la única vía por la que el pronóstico llega a los pesos, y máximo Sharpe llegó a 1.50 a cambio de más volatilidad y concentración. Ninguna estrategia con pronóstico superó a pesos iguales, con un Sharpe de 2.72: en el mejor caso, la probabilidad de superarla fue de 23%.
Checkpoint «Portafolio»
- Todos los pesos suman 1 y ninguno es negativo: 391 portafolios auditados
- Toda beta termina en T y todo periodo de tenencia empieza después de T
- Leíste el intervalo de confianza del Sharpe antes de declarar un ganador
Sigue: Hallazgos
Hallazgos
Hallazgos principales
- El modelo del proyecto no le ganó a no hacer nada. El LSTM de 3 capas con indicadores tuvo un R² fuera de muestra de −0.046: pronosticar rendimiento cero habría sido mejor. La misma red solo con el rendimiento pasado logró +0.155, el mejor de los seis modelos (Tabla 2).
- Más capacidad no fue mejor. Con tan poca memoria en los rendimientos (Figura 7), la red de 1 capa (+0.052) superó a la de 3 (−0.046), y Ridge, sin memoria, ordenó las acciones casi igual que la mejor red.
- El pronóstico tiene que llegar a los pesos. Mínima volatilidad sobre las 10 acciones ignora el pronóstico por completo y logró un Sharpe de 0.19. El filtro CAPM lo subió a 1.01, y máximo Sharpe a 1.50.
- Ninguna estrategia con pronóstico superó a pesos iguales. Repartir en partes iguales logró un Sharpe de 2.72, contra 1.55 del S&P 500 y 1.01 del pipeline original. Con 18 meses fuera de muestra los intervalos son anchos, y ninguna diferencia a favor de un modelo queda demostrada (Tabla 4).
- Pronosticar rendimientos y no precios evitó el problema de extrapolar fuera del rango de entrenamiento que tenía la primera versión (Figura 8).
Checklist metodológico verificado
Cada punto se verifica con código en el notebook. Si alguno falla, la celda se detiene con un error en vez de dejar pasar un resultado contaminado.
- 360 entrenamientos auditados: escalado, purga, embargo y orden temporal correctos.
- 15 recálculos de indicadores sobre series recortadas coinciden con la serie completa.
- 15 objetivos recalculados desde los precios coinciden.
- 391 portafolios auditados: beta hasta T, tenencia después de T y pesos válidos.
- 8 modelos con 17 × 10 pronósticos cada uno.
Limitaciones y trabajo futuro
El proyecto demuestra el criterio correcto: evaluar sin fugas, contra alternativas simples y fuera de muestra. Sus resultados describen este caso, pero todavía no alcanzan para generalizarlos. Para llevarlo a una revista académica o a un sistema que opere dinero real, estos son los cuatro frentes a fortalecer:
- Universo. Usar los constituyentes históricos del S&P 500 en cada fecha de decisión, no las acciones que hoy sabemos que sobrevivieron y ganaron. Así se elimina el sesgo de supervivencia, que aquí infla el desempeño de cualquier estrategia, empezando por pesos iguales.
- Periodo. Extender la evaluación fuera de muestra a por lo menos 10 o 15 años e incluir varios regímenes de mercado: alcistas, bajistas, de alta inflación y de crisis. Un resultado que solo se sostiene en un mercado alcista no es un resultado.
- Robustez. Entrenar cada red con varias semillas y reportar promedio y dispersión; comparar pronósticos con la prueba de Diebold-Mariano y diferencias de Sharpe con la de Ledoit y Wolf; corregir por comparaciones múltiples con el Deflated Sharpe Ratio, y medir la sensibilidad a costos, horizonte e hiperparámetros. Para producción, además, monitorear la deriva de los datos y definir de antemano qué resultado haría retirar el modelo.
- Encuadre. Presentarlo como una replicación crítica: muchos artículos que combinan LSTM y Markowitz reportan resultados inflados por fugas como las que este proyecto corrige. Si el resultado se mantiene con un universo y un periodo amplios, que un modelo de Machine Learning no supere a pesos iguales es en sí mismo una contribución, en línea con DeMiguel, Garlappi y Uppal (2009).
Lo que realmente aprendiste
Qué te llevas: un modelo solo vale lo que gana contra la alternativa simple. Sin la media histórica, el paseo aleatorio y pesos iguales como vara, un error bajo o una curva que sube parecen un logro.
Qué repetirías: la evaluación walk-forward con purga, y verificar con código cada supuesto de no-fuga antes de mirar un solo resultado.
Qué evitarías: pronosticar precios, y calcular el rendimiento esperado con información que el día de invertir todavía no existía.
¿Listo para adaptarlo a tu propio caso? La siguiente sección es justo para eso «una guía para identificar qué tocar del código antes de bajarlo y ejecutarlo tú mismo». Ir a Replica este proyecto
Parte 3 de 3
Replica este proyecto
Cómo adaptarlo a tu propio caso. Este sitio no ejecuta código «no hay sandbox ni notebook interactivo». Lo que sí puede darte es claridad total sobre qué parte del pipeline tocar cuando bajes el código y lo corras con tus propios datos, tu propio modelo o tu propio objetivo.
Esta sección reutiliza exactamente las mismas bifurcaciones ("¿Y si tu caso es distinto?") que ya viste en cada paso «aquí las juntamos para que las apliques a tu proyecto concreto».
Punto por punto: qué hacer con cada decisión clave
Si ya jugaste con el Explorador de decisiones, esto retoma cada una donde la dejaste — con la recomendación puntual para tu propio caso.
¿Solo precio de cierre o con indicadores técnicos?
Empieza solo con el rendimiento y agrega indicadores uno por uno, midiendo cada vez el R² fuera de muestra contra el paseo aleatorio. Si tu historial es corto, vigila además cuántas filas se pierden por las ventanas móviles.
¿Cuántas capas LSTM y cuántas unidades?
construir_rnn() es la única pieza que reemplazas si cambias de arquitectura; el resto del pipeline solo espera un rendimiento esperado por activo. Antes de agregar capas, compárala contra Ridge con la misma ventana: si no le gana, la memoria no está aportando.
¿Incluir todos los activos en Markowitz o filtrar antes con CAPM?
Sin un benchmark de mercado claro (cripto, activos alternativos), este es el primer paso que hay que repensar: decide el proxy de mercado antes de calcular ninguna beta. Y recuerda que con mínima volatilidad el filtro es la única vía del pronóstico.
¿Minimizar volatilidad o maximizar el ratio de Sharpe?
Cambiar el objetivo es un ajuste local dentro de la llamada a scipy.optimize.minimize; el resto del pipeline no cambia. Si tus rendimientos esperados vinieran de una fuente más confiable que un modelo (guía de la empresa, consenso de analistas), máximo Sharpe gana sentido.
Qué puedes cambiar sin romper nada
- El universo de activos «cualquier lista de símbolos que exista en Yahoo Finance funciona con el mismo código de descarga: cambia
SYMBOLS». - El horizonte «
Hdefine a la vez el objetivo, el periodo de tenencia y las unidades de covarianza y tasa; cambiarlo de 21 a 63 días reajusta todo el pipeline». - La función objetivo de Markowitz «pasar de mínima volatilidad a máximo Sharpe es un cambio local dentro de la llamada a
scipy.optimize.minimize». - El rango de fechas «
FECHA_INICIAL,FECHA_FINALeINICIO_BACKTESTviven en la celda de configuración; moverlos no afecta la arquitectura del pipeline». - Los costos de transacción «
COSTO_TRANSACCIONestá en 10 puntos base; súbelo para ver qué estrategias dependen de rotar mucho».
Qué es más difícil de tocar «y por qué»
- Agregar una familia de modelos nueva «una red recurrente distinta solo cambia
construir_rnn, pero un modelo estadístico como ARIMA o GARCH necesita su propia rama enentrenar_y_predecir, con su propio ajuste y su propia validación temporal». CAPM y Markowitz no se ven afectados, porque solo reciben un número por activo. - Cambiar el benchmark de CAPM «si tu universo no tiene un índice de mercado obvio (por ejemplo, activos alternativos), decidir qué usar como referencia es una decisión de dominio, no técnica, y afecta directamente qué acciones sobreviven el filtro».
- Permitir posiciones en corto «no es solo cambiar una restricción numérica»; cambia la interpretación económica de "peso negativo" y cómo reportas el riesgo del portafolio.
Guía de auto-diagnóstico «antes de bajar el código»
Responde esto para ti mismo primero. No es un cuestionario para entregar «es para que sepas, antes de tocar una línea, en qué parte vas a pasar más tiempo».
1. ¿Tu universo de activos tiene un benchmark de mercado claro?
Investiga: si no cotizan contra un índice reconocido (S&P 500, Nasdaq, etc.), necesitas decidir qué usarás como proxy de "mercado" para calcular beta.
Señal de que vas bien: puedes justificar en una frase por qué ese benchmark representa el riesgo sistemático de tu universo.
2. ¿Tu variable a predecir tiene memoria de corto plazo o es esencialmente ruido?
Investiga: revisa la autocorrelación de tu serie antes de entrenar nada. Si es cercana a cero, un LSTM probablemente no va a superar a una media móvil simple.
Señal de que vas bien: tu validation loss baja de forma consistente y no solo memoriza ruido «si no baja, el problema puede no ser la arquitectura sino la naturaleza del dato».
3. ¿Necesitas restricciones distintas en el optimizador (short-selling, límites por sector, número mínimo de activos)?
Investiga: cada restricción nueva se agrega como una entrada más en la lista constraints de scipy.optimize.minimize «revisa la documentación de SLSQP antes de improvisar la sintaxis».
Señal de que vas bien: el optimizador converge (no lanza error de factibilidad) y los pesos resultantes cumplen tus restricciones nuevas exactamente, no de forma aproximada.
Variantes ya pensadas, por si buscas un punto de partida
- Variante 1 — Portafolio de criptomonedas. Cambia el universo por los tickers de
yfinancepara cripto (ej.BTC-USD,ETH-USD). El punto que requiere trabajo real es CAPM: no hay un "mercado" cripto tan establecido como el S&P 500 «investiga qué índice usarías como proxy antes de calcular betas». - Variante 2 — Comparar LSTM contra un modelo GARCH. En vez de reemplazar el LSTM, córrelo junto a un modelo GARCH y compara qué estimador de rendimientos/volatilidad produce un mejor ratio de Sharpe out-of-sample. Esta comparación empírica es un buen eje de contribución original si estás pensando en una tesis.
- Variante 3 — Ampliar a un índice completo con clustering. Para escalar de 10 a 100+ activos sin entrenar cien modelos LSTM, agrupa acciones similares con k-means sobre sus retornos históricos y entrena un modelo por cluster. CAPM y Markowitz siguen funcionando igual una vez que tienes los rendimientos esperados por activo.
Más información y recursos adicionales
Este proyecto no está solo. Combinar pronóstico de rendimientos con Machine Learning y optimización de Markowitz es un área activa de investigación, y estos tres trabajos recientes lo abordan desde ángulos distintos «no son trabajo propio de FuzzyFrog.AI, se enlazan como referencia del nivel y el tipo de solución».
- Ślusarczyk & Ślepaczuk (2025), «Optimal Markowitz portfolio using returns forecasted with time series and machine learning models», Journal of Big Data. Compara DMLP, LSTM, CNN, Random Forest, SVR y ARIMA como fuente de rendimientos esperados para Markowitz, la misma pregunta central de este proyecto, con un universo mucho más amplio de acciones del Dow Jones.
- Huynh & Ta (2025), «Black–Litterman portfolio optimization based on GARCH–EVT–Copula and LSTM models», Annals of Operations Research. Usa una LSTM para estimar las "opiniones" del modelo Black-Litterman en vez de partir solo de la media histórica, una alternativa a CAPM como filtro de expectativas de rendimiento.
- Nguyen (2025), «Advanced investing with deep learning for risk-aligned portfolio optimization», PLOS ONE. Compara LSTM y 1D-CNN contra tres objetivos de optimización distintos «mínima volatilidad, paridad de riesgo y máxima caída», en vez de solo mínima volatilidad y máximo Sharpe como aquí.
Adáptalo con IA
Lo anterior es la vía manual: tú decides qué tocar y lo escribes. Esta es la vía asistida — un prompt ya armado con el contexto del proyecto, las mismas restricciones que evitaron los errores comunes de cada etapa, y los mismos checkpoints como criterios para verificar lo que el modelo te entregue.
CONTEXTO
Voy a adaptar un pipeline de Machine Learning para optimización de carteras de inversión, con estas etapas en este orden: (1) pronóstico del rendimiento logarítmico a 21 días de cada activo, (2) filtro de activos con CAPM: entra solo el activo cuyo pronóstico supera su rendimiento exigido, (3) optimización de pesos con Markowitz (mínima volatilidad o máximo Sharpe) y (4) backtest walk-forward fuera de muestra con costos. Voy a correrlo con mi propio universo de activos, mi propio rango de fechas y, si aplica, mi propio modelo u objetivo de optimización. No cambies el orden de las etapas.

RESTRICCIONES (no las rompas al generar o modificar código)
1. En cada fecha de decisión T, usa solo información disponible hasta T: el escalador se ajusta solo con las filas de entrenamiento, y ninguna muestra entra al entrenamiento si su objetivo termina después de T (purga). La validación interna va separada del ajuste por un embargo igual al horizonte.
2. Pronostica rendimientos, no niveles de precio, y exprésalo todo en el mismo horizonte: rendimiento esperado, covarianza y tasa libre de riesgo.
3. Usa la tasa libre de riesgo del periodo (por ejemplo, el T-bill a 13 semanas), nunca un valor fijo.
4. Compara cualquier modelo contra la media histórica y el paseo aleatorio, y cualquier portafolio contra pesos iguales y el índice de mercado, fuera de muestra y con costos de transacción.

CRITERIOS DE ACEPTACIÓN (verifica esto antes de dar el resultado por bueno)
1. Hay un assert que comprueba que ningún objetivo de entrenamiento termina después de T y que el escalador se ajustó solo con filas anteriores a la validación.
2. Los indicadores recalculados con la serie recortada en T dan el mismo valor en T que con la serie completa.
3. Cada beta se calcula con una ventana que termina en T, y cada periodo de tenencia empieza después de T.
4. Los pesos de cada portafolio suman 1 y ninguno es negativo, salvo que explícitamente hayas pedido permitir posiciones en corto.
5. El reporte incluye R² fuera de muestra contra el paseo aleatorio, IC, y el Sharpe de cada estrategia con su intervalo de confianza.

Pídeme confirmar cada criterio de aceptación uno por uno antes de continuar a la siguiente etapa.
Si ya conoces la metodología SDD (Constitution/Verify), estas mismas restricciones y criterios son tu Constitution y tu paso de Verify — úsalos ahí en vez del prompt simple de arriba.
Siguiente paso real: abre el notebook y córrelo tal cual, con GPU, antes de cambiar nada. Ver el resultado base, con sus tablas y su checklist verificado, es lo que te va a dejar claro, con evidencia propia, exactamente dónde necesitas intervenir.
¿Necesitas más ayuda?
¿Tu tesis requiere análisis de datos o modelos de ML? Trabajemos juntos.
Quiero información