/ Proyectos / Salud / Generación de imágenes sintéticas de mamografía
Generación de imágenes sintéticas de mamografía con GAN y momentos de Hu
Una GAN genera imágenes sintéticas de mamografía para balancear clases médicas escasas, evaluada con FID, KID y una métrica propia basada en momentos de Hu.
El cáncer de mama es la principal causa de muerte por cáncer en mujeres en varios países de Latinoamérica, y su detección temprana depende de mamografías bien analizadas. El problema no es la falta de equipos para capturarlas, es la falta de personal médico suficiente para revisarlas todas a tiempo.
Este proyecto se hizo en 2022, apenas meses después de que ChatGPT saliera al público y detonara el boom actual de la inteligencia artificial generativa. La pregunta de fondo era simple: si un modelo generativo puede escribir texto convincente, ¿puede también generar una imagen médica útil para entrenar otro modelo? Se diseñó una GAN para generar imágenes sintéticas de mamografía, y se propuso una métrica propia, los momentos de Hu, para evaluarlas cuando FID y KID no bastaban para interpretar el resultado.
Mapa del casoContenido
- Diagrama de la solución. El pipeline completo, de la imagen real a la evaluación de la sintética
- Construcción de la solución. Cómo una decisión de acotar el problema hizo viable el entrenamiento
- Condiciones del proyecto. Restricciones reales y opciones descartadas antes de construir
- Pasos. Qué se dejó al agente y qué criterio se aplicó en cada uno
- Proceso de iteración. El resultado inesperado documentado sin maquillar
- Descargables. Notebook y repositorio del proyecto
- Lecciones importantes. La lección concreta que deja este caso
Estructura de alto nivelDiagrama de la solución
Pasa el cursor sobre cada bloque para ver qué hace ese paso.
El generador y el discriminador se entrenan en competencia, congelando al discriminador mientras se actualiza el generador, para que la señal de error no se sobre-ajuste a las mismas muestras que produce la propia red generadora.
Cómo se construyóConstrucción de la solución
Condiciones del proyecto
| Restricción | Dato |
|---|---|
| Clases minoritarias con muy pocos casos | Calcificación maligna y masa maligna, las más graves, también las más escasas |
| Privacidad de imágenes médicas | No se pueden compartir ni replicar libremente imágenes reales de pacientes |
| Invariancias no conocidas a priori | A diferencia de dígitos manuscritos, no hay reglas claras de rotación o traslación que simular manualmente |
| Cómputo disponible | Limitado para entrenar imágenes de alta resolución completa |
| Opción | Por qué se descartó |
|---|---|
| Aumento de datos clásico (recortes, rotaciones, filtros) | Genera variantes correlacionadas entre sí, en vez de ejemplos genuinamente nuevos |
| Generar la mamografía completa | Mayor variación de contenido, entrenamiento de la GAN mucho menos estable |
| Generar solo la región de la calcificación | Objeto pequeño y alineable, entrenamiento más estable, opción elegida |
| BatchNormalization en el generador | Se probó explícitamente y no mejoró resultados, se descartó |
Pasos
Preparación del dataset
Agente: propuso usar la mamografía completa como unidad de entrada.
Criterio aplicado: combinar DDSM (negativos) y CBIS-DDSM (positivos), 55.890 ejemplos en total, y acotar la generación a la región de la calcificación en vez de la imagen completa.
Arquitectura del generador
Agente: propuso una arquitectura genérica de GAN convolucional.
Criterio aplicado: Dense → LeakyReLU → Reshape → 6 bloques Conv2DTranspose que up-samplean hasta 256×256×3, descartando BatchNormalization tras comprobar que no mejoraba el resultado.
Entrenamiento adversarial estable
Agente: conectó generador y discriminador para entrenarlos juntos desde el inicio.
Criterio aplicado: pre-entrenar el discriminador con ruido aleatorio, y luego congelarlo (trainable = False) al entrenar el modelo combinado, para que no se sobre-ajuste a las muestras del propio generador.
Métrica propia de evaluación
Agente: propuso limitarse a FID y KID, el estándar de la literatura.
Criterio aplicado: proponer los momentos de Hu sobre imágenes binarizadas como métrica complementaria, porque estas mamografías sí pueden binarizarse con sentido clínico, ya que lo relevante es la forma de la estructura, no su textura.
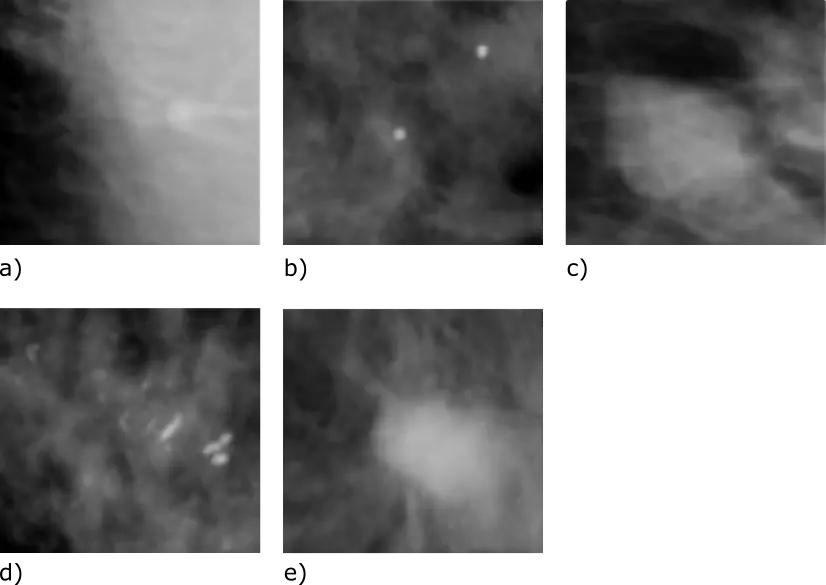
Los momentos de Hu permiten comparar si dos imágenes binarias comparten morfología. A continuación, un ejemplo de mamografía real junto a su versión sintética generada, y por qué la binarización conserva la forma relevante para esta comparación:
Proceso de iteración
Resultado inesperado, no forzado
El aumento con GAN no siempre ganó. Con una CNN sencilla, la mezcla de datos reales y sintéticos alcanzó 0.87 de exactitud, superando tanto a no aumentar (0.83) como al aumento tradicional (0.64). Pero con una arquitectura más compleja, con transferencia de aprendizaje, entrenar solo con datos reales llegó a 0.83 de exactitud, superando a la mezcla con datos sintéticos, que se quedó en 0.70. La clase de masa maligna, además, mostró los valores de FID y KID más altos entre las cinco clases, la más difícil de replicar para la GAN.
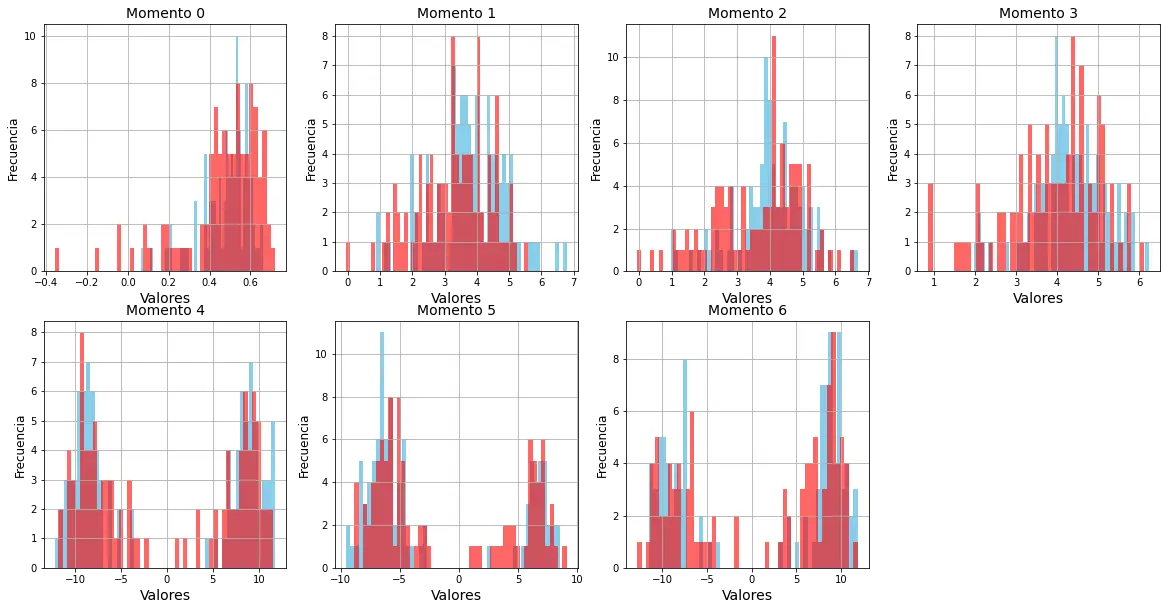
Las distribuciones de momentos de Hu, comparadas entre imágenes reales y generadas, fueron visualmente similares para las cinco clases, lo que respalda cualitativamente la calidad de la generación:
CierreLecciones importantes
El trabajo de mayor impacto ocurrió antes de escribir una sola línea de entrenamiento. Decidir generar solo la calcificación, y no la imagen completa, fue lo que hizo el entrenamiento viable. Y cuando la métrica estándar no bastó para interpretar el resultado, proponer una propia, en vez de conformarse, fue la contribución real del proyecto.
No basta con usar un modelo de lenguaje o un agente de código para ensamblar una GAN estándar. Aquí el criterio humano importó tanto como el código: decidir qué acotar, y qué métrica inventar cuando la disponible no alcanza.
Si quieres ver un enfoque publicado con una comparación similar de métricas de calidad para GAN aplicadas a mamografía, este trabajo es una buena referencia del nivel de la contribución: GAN-based data augmentation to improve breast ultrasound and mammography mass classification.
Termina ya tu proyecto
¿Tienes un proyecto similar y no sabes por dónde empezar? Yo te ayudo a diseñarlo.
El 92% de los profesionales de datos desbloquea sus proyectos al ver ejemplos completos resueltos.
Sin registro. Acceso inmediato